M16 机器学习与 AI 量化
层级:L4 实战与前沿 | 优先级:★★ | 预计学时:12 小时
对应原书:因子 6.8;黑箱第 3 版的机器学习章节
前置知识:M03 的前视;M08 的多次检验;M09 的信息比率上界;M10 的期限对齐。
读书笔记:黑箱机器学习章节
状态:reviewed
数据截至:2016-12|最近复核:2026-10-22
学习目标
-
把 Gu、Kelly 与 Xiu (2020) 的个股 R² 和组合夏普分成两句话,并指出 1.35 属于 NN4 而不是 NN3。
-
用手算区分零基准 R² 和中心化 R²,不把 0.40% 开方之后直接送进基本定律。
-
在一条纯噪声序列上看到:特征若等于当期收益,样本外 R² 是 1;用滞后收益时,这一条路径只有 0.009853。
-
标出标签重叠时该删掉的形成日。
-
说明价值加权多空十分位不是本轮只做多、杠杆上限 1.0 的账户。
-
在一条构造路径上标出三栏:三次止盈都是 0.040000,三次止损都是 −0.020000,两笔竖直栏是 0.005000 与 −0.010000。
-
比较主策略单独出手的胜率 0.500000、期望 0.006875,和元标签过滤后的 0.750000、0.025000。F1 是 0.857143。
本章知识拓扑图
flowchart TB

    Z["t 时已知的特征"] --> G["g 的估计"]

    G --> R2["个股超额收益的样本外 R²"]

    G --> SORT["按预测排序的十分位"]

    SORT --> LS["多空价差"]

    R2 --> LAW["不能直接当成 IC"]

    LS --> ACCT["只做多、杠杆 1.0 放不下空头腿"]

    ACCT --> META["元标签只把多头仓位缩到 0 与 1 之间"]

    META --> TB["三栏:止盈、止损、最大持有期"]

    LEAK["特征用了 t+1 的收益"] --> R2
样本外窗口是 1987–2016。训练按时间向前扩,不用打乱日期的 K 折。
🟢 入门层:个股很难预测,组合仍可能分开
1. 论文实际比较的是什么
Gu、Kelly 与 Xiu(2020,Review of Financial Studies 33(5):2223–2273)用 CRSP 里 NYSE、AMEX 和 NASDAQ 的月度个股,从 1957 年 3 月到 2016 年 12 月。股票只数近 3 万,月均超过 6,200。样本保留了股价低于 5 美元的股票、非常规股份代码和金融股。预测目标是个股超额收益。基准模型只用规模、账面市值比和动量。他们写明不用交叉验证,为的是保持时间顺序。样本外是 1987–2016 这 30 年。
个股层面的月度样本外 R²,全样本一行里:用全部预测变量的 OLS 是 −3.46%,三变量 OLS 是 0.16%,弹性网是 0.11%,主成分回归是 0.26%,偏最小二乘是 0.27%,三层网络 NN3 是 0.40%,四层网络 NN4 是 0.39%。这些是表 1 的百分数。NN3 在市值最大的 1,000 只上是 0.70%,在最小的 1,000 只上是 0.45%。股票层面的拟合,并不是只来自最小的那一段。
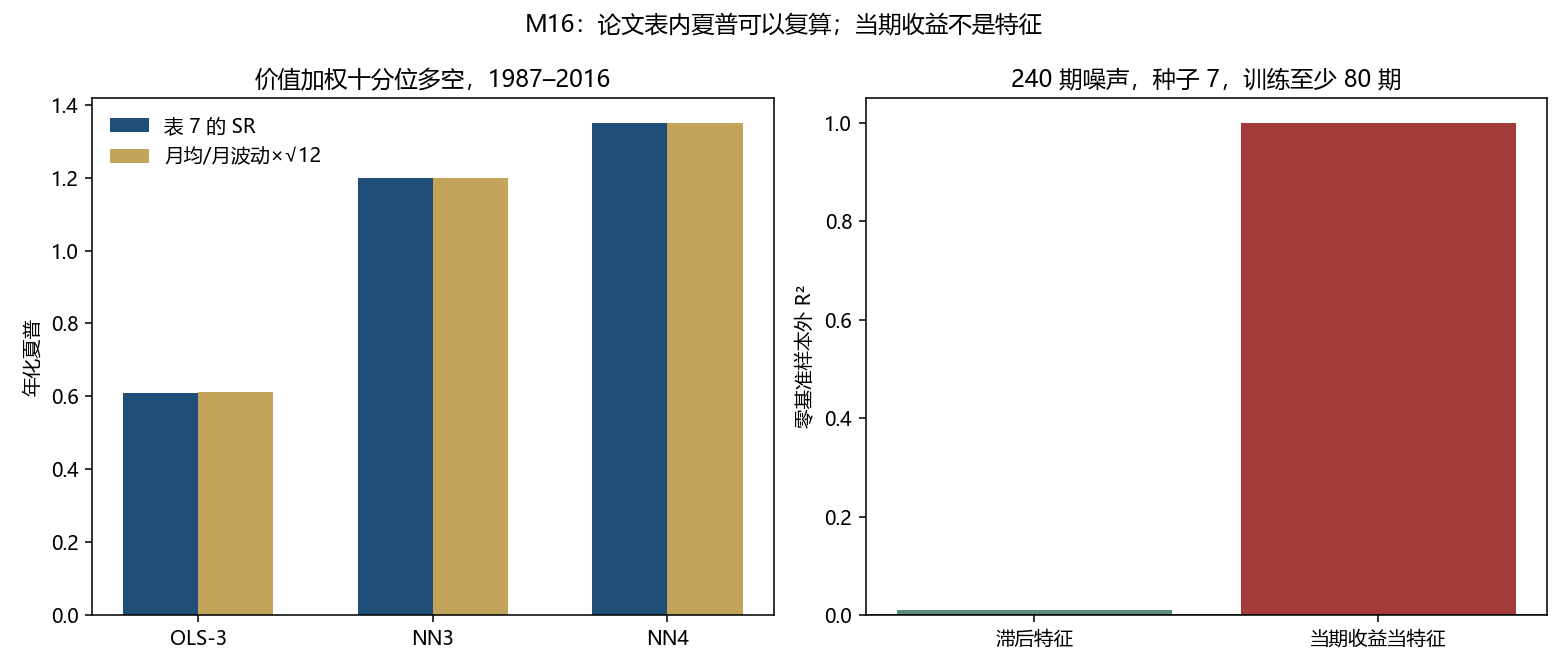
同一篇论文再按预测把股票分成十档,做多最高档、做空最低档,价值加权。表 7 里这条多空的年化夏普:三变量 OLS 是 0.61,NN3 是 1.20,NN4 是 1.35。摘要里的 1.35 和等权 2.45,正文指到 NN4。去掉低于 NYSE 市值 20 分位的股票之后,这篇论文写 NN4 等权多空的夏普是 1.69。等权更高,和「R² 只来自小股票」不是同一句话。
摘要还写,用网络预测对标普 500 做择时,样本外夏普 0.77,买入持有是 0.51。表 6 里 NN3 那一格的 0.26 是两者之差,不是择时策略本身的夏普。
2. 这些夏普不是这本教材的账户
多空十分位是零净额组合:一边做多,一边做空。本轮政策的杠杆上限是 1.0,信号合约不接受负权重。空头腿在这个账户里放不下,1.35 也就不能写成模拟盘会拿到的夏普。表 8 里,NN4 价值加权多空的最大回撤是 51.78%,NN3 是 30.84%。最高的那一列夏普,不是回撤最小的那一列。
论文把持仓变动记成月度换手。NN4 价值加权是 126.81%。这不是 M13 的单边换手 τ。不要把 126.81% 代进 2τ c。
3. 金融序列上,图像和文本里的经验会失真
视觉模型吃的是一张图里成千上万个相关像素,标签往往稳定:猫不会因为下个月的宏观数据改名。个股月超额收益不是这种标签。个人投资者把同一套「加深网络、打乱样本、看验证集」搬过来,通常先碰到下面三件事。
第一件是信噪比极低。把月度信号想成均值 μ、噪声标准差 σ。一组教学输入是 μ = 0.005、σ = 0.10,不是从 CRSP 估出来的市场常数。比值
μ/σ = 0.05, (μ/σ)² = 0.0025
也就是噪声方差里只有 0.25% 留给这个信号。表 1 里最好的个股 R² 也只有零点几个百分点,和这个数量级是同一类现象:模型把平方和解释掉一点点,就已经不容易。图像任务里 90% 的准确率,不能用来预期这里会出现 90% 的 R²。
第二件是非平稳。动量、流动性和波动在论文摘要里被点名为更受重视的变量,它们的溢价会换符号。1957 年到 2016 年训出来的权重,碰到样本结束后的一段行情,没有义务继续工作。这就是结构变化:生成标签的那套机制换了,而网络的层数并没有换。样本在 2016 年 12 月结束,所以它不能给后来某一年的回撤补一个数字。
第三件是截面相关。同一天的股票残差不是 6,200 个独立实验。若残差等相关、相关系数 ρ,横截面均值的方差相对独立情形放大
Nρ + (1 − ρ)
倍。N = 100、ρ = 0.2 时是 20.8。你数出来的股票只数,不能当成基本定律里的独立赌注。M09 的 √BR 要用独立决策的个数,不能用股票只数直接代入。相关性还让「打乱股票再做 K 折」变得更危险:同一天的股票被拆进训练和测试,测试集看见的是同一段宏观冲击。
flowchart TB

    RAW["月超额收益"] --> SNR["信噪比低:平方和几乎都是噪声"]

    RAW --> REG["结构会变:样本内的权重会过期"]

    RAW --> CS["截面相关:只数不等于独立赌注"]

    SNR --> SPLIT["按时间切,不打乱日期"]

    REG --> SPLIT

    CS --> SPLIT
🟡 进阶层:两个分母,以及模型各自在惩罚什么
4. 样本外 R² 的分母是收益平方和
对测试集里的个股超额收益,论文式 (19) 写成
R_oos² = 1 − (Σ (r_(i,t+1) − ˆr_(i,t+1))²) / (Σ r_(i,t+1)²)
| 符号 | 含义 |
| --- | --- |
| r_(i,t+1) | 股票 i 在 t + 1 的超额收益,形成日 t 还不知道 |
| ˆr_(i,t+1) | 只用 t 及以前信息得到的预测 |
| 分母 | 超额收益的平方和,不减去样本均值 |
| 分子 | 预测误差的平方和 |
零预测是分母里的基准:什么都不猜,R² 是 0。预测比零更差,R² 为负。全部预测变量的 OLS 得到 −3.46%,就是比「预测为零」更差。它和三变量模型的夏普 0.61 不是同一个对象。
中心化的决定系数把分母换成 Σ (r − ¯r)²。两个分母只在超额收益的样本均值为 0 时相同。手算四期:
| 超额收益 | 0.02 | −0.01 | 0.03 | 0.01 |
| --- | --- | --- | --- | --- |
| 预测 | 0.01 | 0.00 | 0.01 | 0.00 |
| 误差 | 0.01 | −0.01 | 0.02 | 0.01 |
误差平方和是 0.000700。收益平方和是 0.001500。零基准
R_oos² = 1 − 0.000700/0.001500 = 0.533333
样本均值是 0.0125,离差平方和是 0.000875。同一组误差放进中心化分母:
1 − 0.000700/0.000875 = 0.200000
0.533333 不是相关系数,也不能开方之后叫做 IC。论文表 1 的 0.40% 等于 0.004。若把它当成相关系数的平方,会得到 √0.004 = 0.063246。再乘 √6000,得到 4.8990。这是把基本定律的上界用错了输入。M09 在 IC = 0.05、每年 6,000 个独立赌注、转移系数是 1 时,上界是 3.873,而且那个上界本身也不是预测。0.40% 的 R² 说明个股超额收益的绝大部分平方和没有被解释掉。
5. 表 7 的夏普就是月均除以月波动再乘 √12
价值加权多空的月均收益、月波动和论文给出的夏普:
| 模型 | 月均(%) | 月波动(%) | 表 7 的 SR | 月均/月波动 × √12 |
| --- | --- | --- | --- | --- |
| OLS-3 | 0.94 | 5.33 | 0.61 | 0.6109 |
| NN3 | 2.12 | 6.13 | 1.20 | 1.1980 |
| NN4 | 2.26 | 5.80 | 1.35 | 1.3498 |
NN4 的 2.26 × 12 = 27.12,是月均的 12 倍,不是复利年化。5.80 × √12 约等于论文叙述里的 20.1% 年化波动。复算没有再减无风险利率。表内若已经是超额收益,就不能再减一次。这一列也不是 metrics.py 里日频超额、样本标准差、再乘 √252 的夏普。
左图里两根柱子重合,是因为复算用的就是表 7 印出来的月均和月波动。这不是用 CRSP 把论文重跑了一遍。
6. 当期收益当特征,R² 会变成 1
下面这段只依赖 NumPy。训练窗是 [0, t),预测用 xₜ。x 若是收益本身,xₜ 就是正在被预测的 yₜ。
def r2_zero(y: np.ndarray, yhat: np.ndarray) -> float:

    # 分母用收益平方和。零预测的 R² 定义为 0,比零更差则为负。

    sse = float(np.sum((y - yhat) ** 2))

    sst = float(np.sum(y ** 2))

    return 1.0 - sse / sst


def walk_forward(y: np.ndarray, x: np.ndarray, min_train: int) -> float:

    preds, actual = [], []

    for t in range(min_train, len(y)):

        # 系数只用 t 之前的行。x[t] 若等于 y[t],泄漏发生在这一行,而不是发生在系数里。

        a, b = fit_line(x[:t], y[:t])

        preds.append(a + b * x[t])

        actual.append(y[t])

    return r2_zero(np.array(actual), np.array(preds))
种子 7 的 240 期标准正态噪声,标准差 0.02,至少用 80 期才开始预测。滞后一期的零基准样本外 R² 是 0.009853。把特征换成当期收益,R² 是 1.000000:过去每一行都是完美拟合,斜率是 1,再用当期收益去「预测」当期收益。第 0 期没有滞后,脚本填了 0,预测从第 80 期才开始,这一个填充进不了被评价的那一段。
同一长度、同一训练门槛下,种子 0 到 19 的滞后特征,零基准 R² 平均是 −0.014408。种子 7 的 0.009853 是这一条路径,不是「滞后收益有预测力」。
标签若覆盖其后两期收益,形成日 t 用到的收益序号是 t + 1 和 t + 2。测试形成日取 5 和 6,碰到的收益序号是 6、7、8。形成日 4 用到 5 和 6,形成日 7 用到 8 和 9,两行都与测试标签重叠。留下的训练形成日是 0、1、2、3。这只删标签重叠,没有再加一段禁运期。禁运是为了序列相关,要单独声明长度。
本仓库的默认环境没有把 scikit-learn、LightGBM 或 SHAP 列成必装依赖。下面的系数用 NumPy 解出。预测 t + 1 的收益时,特征停在 t,这和 M03 的 shift(1) 是同一侧。
7. 岭回归收缩,套索可以删掉一列
四行、两个特征的教学样本。特征是 (1, 1)、(2, 2.1)、(3, 2.8)、(4, 10),标签是 0.01、0.02、0.015、0.04。第二列前三行紧贴第一列,最后一行跳到 10,用来看惩罚怎么处理这种尖刺。先把两列和标签都减去各自的均值,均值是 2.5、3.975 和 0.02125。惩罚加在离差系数上,不加在这个均值上。
普通最小二乘是 (X′X)⁻¹ X′y。离差系数是 −0.00060451 和 0.00328683。岭回归把目标写成
‖y − Xb‖² + λ‖b‖², ˆb = (X′X + λ I)⁻¹ X′y
λ = 0.1 时系数变成 −0.00048588 和 0.00324751。两列都还在,绝对值被拉向 0。套索把平方惩罚换成绝对值和。坐标下降在
‖y − Xb‖² + λ₁‖b‖₁
上、λ₁ = 0.01 时,第一列系数变成 0,第二列是 0.00301963。尖刺那一列留下,和它几乎成比例的那一列被删掉。弹性网同时用两种惩罚:
‖y − Xb‖² + λ₂‖b‖² + λ₁‖b‖₁
λ₂ = 0.1、λ₁ = 0.01 时,系数是 0 和 0.00301361。第一列仍然是 0,第二列比纯套索再小一点。这四行不是股票,λ 也不是交叉验证选出来的。它们只说明三件事:岭回归两列都留着但缩小;套索可以正好变成 0,于是做特征筛选;弹性网是两种惩罚一起上。
| 估计 | 第一列 | 第二列 | 惩罚 |
| --- | --- | --- | --- |
| 最小二乘 | −0.00060451 | 0.00328683 | 无 |
| 岭回归 | −0.00048588 | 0.00324751 | λ = 0.1 的平方 |
| 套索 | 0 | 0.00301963 | λ₁ = 0.01 的绝对值 |
| 弹性网 | 0 | 0.00301361 | 上面两种同时 |
Gu、Kelly 与 Xiu 的表 1 里,弹性网的全样本个股 R² 是 0.11%,低于三层网络的 0.40%,也低于偏最小二乘的 0.27%。收缩没有在那一张表上胜过网络。它的好处是系数可核对:哪一列被置零,你看向量就知道。
8. 树拟合残差,网络在这篇论文里没有越深越好
随机森林是很多棵树的平均。每棵树看一份自助样本和一部分特征,树与树之间不把下一棵的目标改成残差。梯度提升则是另一条链:第一棵树拟合标签,下一棵树拟合还没拟合掉的残差,也就是损失对当前预测的负梯度。LightGBM 是这种提升的一种实现,用直方图加速找分裂。本环境不调用它。分裂规则可以用四个人工点看懂。
残差取 0.02、0.01、−0.01、−0.02,特征取 0, 0, 1, 1。分裂前的平方和是
0.02² + 0.01² + 0.01² + 0.02² = 0.0010
在 0.5 处切开。左边均值 0.015,右边均值 −0.015。两边剩下的平方和都是 0.00005,合计 0.0001。这一次分裂把平方和减少 0.0009。随机森林把许多这样的分裂平均掉,单次分裂的偶然性会被冲淡。提升则把 0.0009 这次下降之后的残差再交给下一棵树,所以它更会沿着同一组交互往下钻,也更容易把样本里的阈值记死。单调约束是后一种实现里的开关,要在那个库的文档里打开,不是把树平均一下就会自动出现。
网络在表 1 的全样本一行里,按论文给出的百分数:一层 0.33%,两层 0.39%,三层 0.40%,四层 0.39%,五层 0.36%。NN3 的结构在论文里是 32-16-8。从三层到五层,个股 R² 没有继续上升。在信噪比只有教学例子里那种 0.0025 的量级时,多出来的层主要多记住噪声。这篇论文没有证明「浅层永远优于深层」,它证明的是在这套月频个股任务上,五层没有胜过三层。组合夏普的冠军仍是表 7 的 NN4,那是另一列指标。
9. 向前滚动,以及清除重叠标签之后再禁运
标签若占用了其后几期收益,测试卷的答案会写进训练资料。清除就是把和时间段重叠的复习资料切掉。
考完之后,紧跟着的几天仍可能带着同一批残差。禁运再把这段隔离掉。
向前滚动只保证测试在训练之后。它不会自动做这两刀。
形成日 5 和 6 的标签用到收益 6 到 8 时,形成日 4 和 7 也得从训练里拿掉。
向前滚动已经写在脚本里:预测时点 t 的系数只用 [0, t)。训练窗随着 t 变长,这是扩展窗口。若改成只用最近 W 期,就是滚动窗口。两者都不把未来月份放进系数。论文不用打乱的 K 折,用的就是这种时间顺序。验证在他们的设计里是一段向前滚的 12 个月,不是随机折。
标签若覆盖其后 h 期收益,光向前滚动还不够。测试集的标签占用了一些收益日期,训练行只要用到同一批日期,就要从训练集删掉。这是 López de Prado(2018)书里的清除(purge)。清除之后,测试段紧后面的若干形成日仍可能带着与测试残差相关的特征,所以再删掉一段禁运(embargo)。禁运的长度要单独写明,它不是清除的自动结果。
flowchart LR

    TE["测试形成日"] --> RET["这些标签占用的收益日期"]

    TR["候选训练形成日"] --> OWN["它自己的标签占用哪些收益"]

    OWN --> ASK{"与测试收益相交?"}

    ASK -->|是| DROP["清除"]

    ASK -->|否| EMB{"落在测试段之后的禁运期内?"}

    EMB -->|是| DROP2["再删"]

    EMB -->|否| KEEP["留下"]
沿用脚本里的短例子:一共 8 个形成日,标签长 2,测试是 5 和 6。测试占用收益 6、7、8。形成日 4 占用 5 和 6,形成日 7 占用 8 和 9。留下的是 0、1、2、3。这里没有额外的禁运,4 和 7 已经因为重叠被删掉了。
把序列放长到 12 个形成日,标签仍长 2,测试改为 6 和 7。只做清除时留下
0, 1, 2, 3, 4, 9, 10, 11
测试之后再禁运 2 个形成日,9 被拿掉,留下
0, 1, 2, 3, 4, 10, 11
8 在清除时已经不在,因为它的标签用到了测试也用到的收益。禁运多删的是清除还没碰到的 9。下面的函数把两步分开,方便你改 embargo 看名单变不变。
def purged_with_embargo(n: int, horizon: int, test: range, embargo: int) -> list[int]:

    """删掉标签与测试相交的形成日,再删测试段之后的禁运期。"""

    # 禁运不是清除的副产品。embargo=0 时只做标签重叠。

    test_set = set(test)

    test_returns: set[int] = set()

    for t in test_set:

        test_returns.update(range(t + 1, t + horizon + 1))

    last_test = max(test_set)

    kept: list[int] = []

    for t in range(n):

        if t in test_set:

            continue

        used = set(range(t + 1, t + horizon + 1))

        if not used.isdisjoint(test_returns):

            continue

        if last_test < t <= last_test + embargo:

            continue

        kept.append(t)

    return kept
purged_with_embargo(8, 2, range(5, 7), 0) 得到 [0, 1, 2, 3],与脚本一致。purged_with_embargo(12, 2, range(6, 8), 0) 得到含 9 的那一列,把最后一个参数改成 2 则去掉 9。
🔴 深入层:重要性要能对上列名,生成式模型另有截止日
10. 摘要点名的是动量、流动性和波动
论文摘要写,各方法更重视的预测变量集中在动量、流动性和波动的各种变形。本章没有把图 5 的排名表重排成一张新的名次。M10 已经把这件事接到持有期:量价类变量往往衰减更快,换手假设不能省。
样本在 2016 年 12 月结束。它不包含 2025 年的行情,也不能用来给 M00 里那一段夏季回撤再写一个百分点。若一个模型的重要性主要落在动量上,动量崩溃时它不是另一类风险。这是机制,不是把 1.35 外推到 2025 年。
表 8 还报告 NN4 价值加权多空对五因子加动量的月 α 为 1.76%,t 值 6.00,信息比率 1.18。那是论文自己的回归。本章没有重做,也没有换成 Newey–West。多空 α 仍然要有空头腿。
大模型给新闻打分时,另有一种前视:权重的训练截止日期若晚于新闻日期,输出可以含有后来才发生的结果。只给截止日期之后的文本打分,并保存模型版本和原始输出。这样做挡住的是事后信息,不会自动得到一个可以记进账本的次日相关。M15 的闸门不因为预测来自网络而放开:未知订单仍停新单,审批仍先落库。
11. 不纯度、打乱一列,以及线性模型上的贡献
同一棵树上,一次分裂减少的平方和可以在所有树、所有用到该特征的分裂上加总。这就是平均不纯度减少(MDI)。上一节那一刀把平方和从 0.0010 降到 0.0001,减少 0.0009。若整片森林里这个特征只贡献了这一刀,它的 MDI 就是 0.0009。MDI 偏向取值很多的特征,因为它们有更多机会被选去分裂。它也看的是样本内的树,所以一个被记死的阈值会显得很重要。
排列重要性(MDA)不看树怎么分裂。先在当前模型上算一个损失,再把某一列的取值打乱,损失变差多少就是这一列的重要性。打乱破坏的是这一列和标签的搭配,其他列的数值还在。用第 7 节的离差最小二乘,种子 7 把列打乱一次:基准误差平方和是 0.0000312858。打乱第一列之后变成 0.0000401126,增加 0.0000088268。打乱第二列之后变成 0.0019134662,增加 0.0018821804。第二列重要得多,和套索把第一列置零是同一方向。一次打乱的顺序依赖种子,正式使用时要重复多次再看平均。这一次只演示符号和数量级。
SHAP 把一条预测拆成每个特征的贡献,使贡献之和等于预测相对基准的差。线性模型、并且用特征均值当基准时,第 i 行第 j 列的贡献就是离差 x_ij − ¯xⱼ 乘上系数 bⱼ。仍用那组最小二乘系数,四行贡献是:
| 行 | 第一列 | 第二列 | 合计,即离差预测 |
| --- | --- | --- | --- |
| 1 | 0.00090677 | −0.00977831 | −0.00887154 |
| 2 | 0.00030226 | −0.00616280 | −0.00586055 |
| 3 | −0.00030226 | −0.00386202 | −0.00416428 |
| 4 | −0.00090677 | 0.01980313 | 0.01889637 |
第四行几乎全是第二列的 0.01980313。这和 MDA 里第二列把误差平方和抬高将近 0.0019 是同一件事的两种算法,不是两个互相独立的事实。树模型上的 SHAP 要用那个模型自己的算法,不能把上面的乘法当成森林的输出。本环境不安装 SHAP 库。诊断过拟合时,三者的分工是:MDI 告诉你树在样本内爱用哪一列,MDA 告诉你打乱之后样本外损失是否真的变差,线性贡献告诉你这一行的预测是哪一列推上去的。三列都指向动量的变形时,模型并没有离开 M06 的动量,只是换了一种函数去拟合它。
12. 语言模型能改写代码,不能改写截止日
财报和新闻的情绪分数有两处时钟。文本的发布时间必须早于你打算交易的那个 effective_at。模型权重的训练截止日也必须早于这段文本,或者你只把截止日之后的文本当作样本外。用 2024 年训练完的权重给 2020 年的标题打分,标题本身可以是当时公开的,权重里却可以含有 2020 年之后的价格路径。这和把当期收益当成特征是同一类错误,只是泄漏藏在参数里,不藏在某一列的时间戳上。
个人账户里比较稳的用法是让模型起草研究笔记、解释一段已经跑完的脚本、或者把月度复盘整理成条目。草稿里的数字要回到 figures/M16/plot_ml.py 或论文表格核对之后才能留下。模型写出的下单片段不能在开发机执行。订单仍要先成为带哈希的计划,再按 M15 落账。生成式模型不改变只做多和杠杆上限,也不把表 7 的空头腿变成可以持有的仓位。
一条预测在离开研究层之前,先对下面这张表。缺一行就还不能写进订单计划。
| 检查 | 通过的样子 |
| --- | --- |
| 标签日期 | 收益日期全部晚于特征的最后日期 |
| 训练样本 | 系数没有用到测试标签占用的那些收益 |
| 长标签 | 清除名单和禁运名单分开保存 |
| 验证窗 | 按时间向前,没有打乱月份 |
| 两张表 | 个股 R² 和组合夏普不写在同一格 |
| 表 7 的夏普 | 先确认是 NN3 的 1.20 还是 NN4 的 1.35 |
| 年化 | 月均乘 12 不被写成复利 |
| 换手 | 持仓变动 126.81% 不被代进 2τ c |
| 空头腿 | 只做多、杠杆上限 1.0 的账户里不存在这条腿 |
| 重要性 | 若集中在动量,回到 M06 看动量崩溃 |
| 新闻分数 | 模型截止日早于文本,或文本全部落在截止日之后 |
| 生成代码 | 只作草稿,数字以脚本打印为准 |
13. 三栏打标签,以及只做多账户上的元标签
三栏是一只笼子:上栏止盈,下栏止损,竖栏是交卷时间。谁先被碰到,标签就是谁。
元标签不改方向。传统规则当司机,只在做多时给出 +1;模型当副驾,按这次会不会碰到止盈,把仓位踩在 [0, 1]。
概率 0.2 是两成仓,不是做空。表 7 的多空夏普靠空头腿,这里没有那条腿。
竖直栏上的小赚仍记 0:它没有碰到上栏,不能把没止盈写成成功。
固定期限的标签,例如「未来 20 日涨跌」,只看终点的符号。持有期内先跌破止损、或者波动已经放大到同样的 20 日涨跌不再是同一笔风险,这个标签都看不见。López de Prado(2018)的三栏改成问:从进场价出发,谁先被碰到。
进场日已经知道的波动率记为 σ。上轨是止盈 +k_ptσ,下轨是止损 −k_slσ,竖直栏是最大持有期 H。路径用收盘价。先碰到下轨,标签收益记 −k_slσ;先碰到上轨,记 +k_ptσ。越过栏位的那一跳不记进收益,因为教学约定在栏位上离场。同一根收盘若两边都穿过,先记下轨:只做多账户不知道日内谁先发生,不能把已经打穿止损的日子记成止盈。两根水平栏都没碰到,就在第 H 根按当时的简单收益离场,这是竖直栏。
元标签问的不是「价格会涨还是会跌」。主模型已经决定了方向。元标签只问:这一次多头会不会碰到止盈栏。碰到是 1,止损或竖直栏都是 0。竖直栏上的小幅上涨仍然是 0,因为它没有打到上轨。
这套划分适合本仓库的只做多账户,原因在两层的分工,不在模型的名字。
第一层是主模型。它用一条说得清的规则决定方向,例如 M02 的 10 个月均线突破,或 12-1 动量。账户只做多,所以它只在规则成立时给出 +1,不给出空头。下面八笔就是这种已经发出的多头信号。这条构造路径不再重算均线。
第二层是元模型。它做一个二分类:预测这一次 +1 会不会碰到上轨。预测概率落在 [0, 1],直接当成仓位。概率 0.2 就是两成仓,不是做空。单笔仓位因此不超过 1,杠杆上限 1.0 在「同一时间只有一笔」时自然满足。表 7 的多空十分位靠空头腿把夏普做出来,这里没有那条腿。八笔在时间上相隔 5 根、持有窗只有 4 根,持仓不重叠。若以后多只股票的持仓重叠,仓位相加之后仍要截到 1.0,元标签不会替你做这一步。
教学参数:σ = 0.02,k_pt = 2,k_sl = 1,H = 4。上轨收益是 0.040000,下轨收益是 −0.020000。信号在下标 0、5、10、15、20、25、30、35。分数在进场时已经知道,阈值 0.5 以上才把硬预测记为 1。
| 下标 | 第几根离场 | 栏 | 收益 | 元标签 | 分数 | 硬预测 |
| --- | --- | --- | --- | --- | --- | --- |
| 0 | 2 | 上轨 | 0.040000 | 1 | 0.8 | 1 |
| 5 | 2 | 下轨 | −0.020000 | 0 | 0.2 | 0 |
| 10 | 4 | 竖直 | 0.005000 | 0 | 0.3 | 0 |
| 15 | 2 | 上轨 | 0.040000 | 1 | 0.7 | 1 |
| 20 | 2 | 下轨 | −0.020000 | 0 | 0.6 | 1 |
| 25 | 2 | 上轨 | 0.040000 | 1 | 0.9 | 1 |
| 30 | 2 | 下轨 | −0.020000 | 0 | 0.1 | 0 |
| 35 | 4 | 竖直 | −0.010000 | 0 | 0.4 | 0 |
下标 10 的收益是正的,元标签仍是 0。过滤掉它,是因为没碰到止盈,不是因为亏了。
主策略八笔都做:正收益 4 笔,胜率 0.500000。收益和是 0.055,期望 0.006875。
硬过滤留下分数不低于 0.5 的四笔:0.040000、0.040000、−0.020000、0.040000。胜率 0.750000,期望 0.025000。被拿掉的两笔止损是下标 5 和 30。留下的假阳性是下标 20。
真阳性 3,假阳性 1,假阴性 0。精确率 ¾ = 0.750000,召回 3/3 = 1.000000。
F₁ = (2 × 0.75 × 1) / (0.75 + 1) = 0.857143
仓位用分数本身、不再硬切时,八笔的仓位收益是 0.032、−0.004、0.0015、0.028、−0.012、0.036、−0.002、−0.004,和为 0.0755,平均 0.0755/8 = 0.0094375。脚本按六位打印 0.009437。这是每笔信号的期望,仓位可以小于 1,也不会小于 0。
labeled = triple_barrier_labels(

    close, events, sigma=0.02, k_pt=2.0, k_sl=1.0, horizon=4,

)

pred = (score >= 0.5).astype(int)

stats = meta_label_f1_precision(labeled["meta"], pred)
figures/M16/plot_ml.py 的 long_only_meta_demo 打印上表和 0.500000、0.006875、0.750000、0.025000、0.009437、0.857143。标签窗在这八笔上不重叠,所以没有再做第 9 节的清除。真实的三栏若共用后面的收益,清除仍然要做。
14. 时间顺序上的 Pipeline 对照
生产里常用的写法是:StandardScaler 与分类器放进 sklearn.pipeline.Pipeline,切分用 TimeSeriesSplit,分类器可以是 lightgbm.LGBMClassifier。TimeSeriesSplit 保证测试折晚于训练折。它不知道标签占用了未来哪几根收益,所以三栏重叠时,清除和禁运仍要先按第 9 节做完,再把剩下的行交给这个切分。
本仓库默认不安装 scikit-learn 和 lightgbm。可选库没装上时,下面的调用降级,打印 sklearn_lgbm skipped。第 13 节的胜率和 F1 不依赖这次拟合。装上之后,概率输出仍要截到 [0, 1],并且不能为了提高分数去学习一个负仓位。
def production_pipeline_reference(features: np.ndarray, labels: np.ndarray) -> None:

    """TimeSeriesSplit 不清除重叠标签。三栏路径重叠时,先做清除再切分。"""

    try:

        from lightgbm import LGBMClassifier

        from sklearn.model_selection import TimeSeriesSplit

        from sklearn.pipeline import Pipeline

        from sklearn.preprocessing import StandardScaler

    except ImportError:

        print("sklearn_lgbm", "skipped")

        return

    pipe = Pipeline([

        ("scale", StandardScaler()),

        ("clf", LGBMClassifier(n_estimators=20, learning_rate=0.1, verbosity=-1)),

    ])

    splitter = TimeSeriesSplit(n_splits=2)

    for fold, (train, test) in enumerate(splitter.split(features), start=1):

        pipe.fit(features[train], labels[train])

        prob = pipe.predict_proba(features[test])[:, 1]

        print("fold", fold, "mean_prob", f"{float(prob.mean()):.6f}")
真实案例
案例 1:1.35 的那一列是 NN4
表 7 价值加权多空,NN4 月均 2.26%、月波动 5.80%,夏普 2.26/5.80 × √12 = 1.3498,论文记为 1.35。NN3 是 1.1980,对上表内 1.20。三变量 OLS 是 0.6109,对上 0.61。摘要没有把 1.35 写成 NN3。NN4 这一列的最大回撤在表 8 是 51.78%。只做多且杠杆不超过 1 的账户,做不成这张表里的空头腿。
案例 2:实验室的季频秩相关,不是表 7 的 1.35
momentum_plus_lab/outputs/rank_ic_summary.csv 用 45 个季度的秩相关,衡量信号和下个季度收益的对齐。经典 12-1 的平均秩相关是 0.0086,标准误 0.0406,t = 0.21。中期 6-1 是 0.0466,t = 1.40。52 周新高接近度是 −0.0610,t = −1.60。45 个季度上,t = 2 大约要求平均秩相关是标准误的两倍。这三行都没有走到那里。
把表 1 的 0.40% 开方再乘 √6000,得到的 4.8990 用的是另一套分母。秩相关 0.0086 也不能代入 α = IC × σ × z 去造一个账户的信息比率。四期手算的零基准 R² = 0.533333 和中心化 R² = 0.200000 留在习题里。种子 7 上滞后特征的样本外 R² = 0.009853、二十个种子平均 −0.014408,和这 45 个季度是两类样本。一条为正、一组平均为负,都说明单次正值不够当成可交易的夏普。
案例 3:清除和禁运仍是两份名单
12 个形成日、标签长 2、测试是 6 和 7。只清除重叠时,9 还在训练名单里。禁运 2 个形成日之后,9 被拿掉,留下 0、1、2、3、4、10、11。短例子里的 [0, 1, 2, 3] 没有这段禁运。两套名单是两次调用,不是同一个输出。四行教学样本上的岭回归系数 −0.00048588 与 0.00324751,以及套索把第一列收成 0,留在习题里核对,不代替表 1 的弹性网 R²。只做多且杠杆不超过 1 的账户,仍然做不成表 7 里 NN4 的空头腿。最大回撤 51.78% 是那条多空的路径。
方法论来源
| 概念 / 模型 | 核心文献或规范出处 |
| --- | --- |
| 个股预测与组合夏普 | Gu, Kelly & Xiu (2020), RFS 33(5)。NN4 夏普 1.35,NN3 是 1.20 |
| 样本外 R² | 分母是超额收益的平方和,不是去均值之后的 R²,所以可以为负 |
| 清除与禁运 | Purged K-Fold。长标签的清除名单和禁运名单分开 |
| 线性贡献 | (x_ij − ¯xⱼ) bⱼ。SHAP 库仍不调用 |
| 三栏与元标签 | López de Prado (2018)。主模型只出多头,元标签把仓位缩到 [0, 1] |
| 工业库对照 | Pipeline、TimeSeriesSplit、LGBMClassifier。可选库没装上时降级,打印 sklearn_lgbm skipped |
| 图 | plot_ml.py |
| 季频秩相关 | Labs/momentum_plus_lab/outputs/rank_ic_summary.csv,45 个季度 |
💡 思考回顾与巩固
核心认知纠偏
| 误区 | 反例 | 用法 |
| --- | --- | --- |
| 1.35 是 NN3 的夏普 | 表 7 里 NN3 是 1.20,NN4 是 1.35 | 先对列名 |
| 0.61 是「全部变量 OLS」的夏普 | 全部变量的个股 R² 是 −3.46%;0.61 是三变量多空 | 两个表 |
| 0.40% 开方就是 IC,再乘 √6000 就是 IR | 得到 4.8990,分母并不是相关系数的分母 | 上界要有自己的 IC |
| 等权夏普更高,所以 R² 只来自小股票 | 最大 1,000 只上 NN3 是 0.70%,最小 1,000 只是 0.45% | 拟合和组合权重分开 |
| 表 6 的 0.26 就是择时夏普 | 0.77 减 0.51 等于 0.26 | 0.26 是增益 |
| 126.81% 可以代进 2τ c | 那是论文的持仓变动,不是单边换手 | 先对齐定义 |
| 滞后特征算出正的 R² 就说明有信号 | 种子 7 是 0.009853,二十个种子平均 −0.014408 | 看一组路径 |
| 多空夏普可以直接放进只做多账户 | 空头腿和杠杆上限冲突 | 先看能不能下单 |
| 打乱 K 折只要最后看样本外就安全 | 当期收益当特征时 R² 是 1 | 特征时间戳先检查 |
| 清除重叠就已经包含禁运 | 12 期例子里清除后 9 还在,禁运 2 期才删掉 9 | 两步分开写 |
| 网络越深,表 1 的 R² 越高 | 五层是 0.36%,三层是 0.40% | 看论文给出的那一行 |
| 套索和岭回归都会把系数收成 0 | 这四行上岭回归两列都还在,套索把第一列收成 0 | 先看向量 |
| 2016 年截止的表可以解释 2025 年的回撤幅度 | 样本没有那些月份 | 回撤数字回到 M00 |
| 元标签会学出空头腿 | 概率落在 [0, 1],下标 20 的假阳性仍是多头亏损,不是负权重 | 仓位只缩小,不反向 |
费曼自测
-
为什么全部变量 OLS 的 −3.46% 和三变量多空的 0.61 不能写成「OLS 夏普很差,所以是 0.61」?
-
零基准 R² 是 0.533333 时,为什么不能说模型解释了 53% 的离差?
-
泄漏的那条路径为什么刚好是 1,而不是一个偶然的大数?
-
表 6 的 0.26 和摘要的 0.77 是什么关系?
自测要点
1. −3.46% 是个股月超额收益的样本外 R²,分母是收益平方和,模型比预测为零更差。0.61 是另一张表里、只用三个变量的价值加权多空夏普。对象、模型和指标都不同。 2. 0.533333 的分母是 0.001500,也就是收益平方和。离差平方和是 0.000875,同一误差得到 0.200000。53% 说的是比零预测好多少,不是比均值好多少。 3. 特征等于标签时,过去每一行的拟合都是斜率 1、截距 0。用当期收益预测当期收益,误差是 0,零基准 R² 就是 1。它不依赖种子。 4. 摘要的择时夏普是 0.77,买入持有是 0.51,差是 0.26。表 6 报告的是这个差。把 0.26 当成策略夏普,会把增益写成水平。四维习题
A. 概念题
- 论文为什么写明不用交叉验证?
- 最大 1,000 只股票上的 R² 高于最小 1,000 只,和等权多空夏普高于价值加权,分别说明什么?
- 标签覆盖其后两期时,测试形成日 5 和 6 为什么要删掉形成日 4 和 7?
- 杠杆上限 1.0、只做多的账户,缺的是表 7 里的哪一条腿?
B. 计算题
- 用月均 2.26%、月波动 5.80% 复算年化夏普。它对应表 7 的哪一列?NN3 的 2.12% 和 6.13% 呢?
- 四期超额收益 0.02、−0.01、0.03、0.01,预测 0.01、0、0.01、0。零基准 R² 和中心化 R² 各是多少?
- 把 0.40% 当成相关系数平方,再乘 √6000。得到的数是什么,不是什么?
- 0.77 与 0.51 的差是多少?它等于表 6 的哪一个数?
- 四行教学样本上,岭回归 λ = 0.1 的两个系数是多少?套索 λ₁ = 0.01 的第一列是多少?
- 12 个形成日、标签长 2、测试 6 和 7。只清除时 9 在不在?禁运 2 期之后呢?
- 第 13 节里,主策略的胜率和期望是多少?硬过滤之后呢?下标 10 的收益为正,为什么元标签仍是 0?
- 精确率、召回和 F₁ 各是多少?
TimeSeriesSplit为什么还不能代替第 9 节的清除?
C. 编程实战题
- 运行
figures/M16/plot_ml.py。核对 0.6109、1.1980、1.3498、0.533333、0.200000、0.009853、1.000000、−0.014408,以及留下的形成日[0, 1, 2, 3]。 - 调用
purged_with_embargo(12, 2, range(6, 8), 0)和同一个函数、禁运改成 2。核对两份名单。不要为了本题安装 LightGBM 或 SHAP。 - 把噪声长度改成 48、最少训练改成 16,仍用种子 7。说明这一次滞后特征的 R² 为什么不能单独当成「发现了信号」。不要把改完的脚本提交成新的论文结论,也不要在开发机发单。
D. 个人实战思考题
- 你只有月度调仓、不能做空。NN4 的 1.35 里,哪一部分你根本下不了单?
- 一个新闻模型的训练数据截止到 2024 年。你用它给 2020 年的标题打分,问题出在权重里还是出在标题文本里?
- 种子 7 的滞后 R² 是正的 0.009853。你会因此把滞后收益放进实盘特征吗?
- MDI 给出某个量价特征很高。MDA 在打乱之后损失几乎不变。你还把它留在模型里吗?
完整参考答案与解析
**A1.** 随机把月份分进训练和测试,会让 t + 1 的收益出现在训练里。论文把验证窗按时间向前滚,样本外固定在 1987–2016,就是为了不打乱这个顺序。 **A2.** NN3 在最大 1,000 只上的月度 R² 是 0.70%,在最小 1,000 只上是 0.45%。这说的是个股拟合。等权多空夏普 2.45、去掉 NYSE 市值 20 分位以下之后是 1.69,说的是组合怎么加权。后一个下降说明小股票抬高了等权组合,前一个比较说明拟合本身不是只存在于最小的 1,000 只。 **A3.** 形成日 5 的标签用收益 6 和 7,形成日 6 的标签用收益 7 和 8。形成日 4 的标签用到收益 6,形成日 7 的标签用到收益 8。训练里留下这些行,测试标签的成分就进了训练集。不重叠的是形成日 0、1、2、3。 **A4.** 缺的是做空最低档的那一条腿。价值加权多空是零净额,多头和空头都有名义。只做多、杠杆不超过 1 时,表 7 的夏普不是账户能实现的夏普。最大回撤 51.78% 也是那条多空的路径,不是只做多的路径。 **B5.** 2.26/5.80 × √12 = 1.3498,对应 NN4,论文记为 1.35。2.12/6.13 × √12 = 1.1980,对应 NN3 的 1.20。三变量是 0.94/5.33 × √12 = 0.6109。三个复算都没有再减无风险利率。2.26 × 12 = 27.12 是月均乘 12,不是净值复利。 **B6.** 误差平方和 0.000700,收益平方和 0.001500,零基准 R² = 0.533333。均值 0.0125,离差平方和 0.000875,中心化 R² = 0.200000。 **B7.** √0.004 = 0.063246,乘 √6000 得 4.8990。它是把表 1 的百分数误当成相关系数平方之后,再套进独立赌注的上界。它不是 IC,不是论文报告的夏普,也不是账户的信息比率。 **B8.** 0.77 − 0.51 = 0.26。表 6 的 NN3、标普 500 那一格是这个增益。策略水平是 0.77。 **B9.** 特征和标签先减去均值 2.5、3.975、0.02125。岭回归系数是 −0.00048588 和 0.00324751。套索第一列是 0,第二列是 0.00301963。最小二乘是 −0.00060451 和 0.00328683,弹性网是 0 和 0.00301361。 **B10.** 只清除时留下 0、1、2、3、4、9、10、11,9 还在。禁运 2 个形成日之后留下 0、1、2、3、4、10、11,9 不在。8 在清除阶段就已经不在。 **B11.** 主策略胜率 0.500000,期望 0.006875。硬过滤后胜率 0.750000,期望 0.025000。下标 10 在第 4 根离场,收益 0.005000,没有碰到 +2σ 的上轨,元标签按定义是 0。竖直栏上的小赚不是止盈。 **B12.** 真阳性 3,假阳性 1,假阴性 0。精确率 0.750000,召回 1.000000,F₁ = 0.857143。`TimeSeriesSplit` 只保证测试折更晚。它不看标签占用了哪些收益。三栏重叠时仍要先清除、再禁运,然后才把剩下的行送进 Pipeline。可选库没装上时这一格降级,打印 `sklearn_lgbm skipped`。 **C13–C15.** 左图复算表 7,不重新下载 CRSP。下面只复算夏普的年化,不调用学习库,也不提交订单。 NN4 的 1.35 和 NN3 的 1.20 不是同一个格子。长度改成 48 时,样本外 R² 会换一个数。 **D16.** 下不了单的是空头腿,以及按十档满仓多空所要求的总名义。你能做的至多是论文多头那一档的一个只做多近似,而且还要再过单名上限、费用和 M13 的成交约束。那个近似的夏普,表 7 没有给你。 **D17.** 问题在权重。标题文本可以是 2020 年当时已经公开的,但 2024 年才训练完的权重见过后来的价格和新闻。截止日之后的文本才是这个模型的样本外。保存版本和原始输出,是为了以后还能对上同一次打分。 **D18.** 不会。0.009853 是二十个种子平均 −0.014408 所描述的噪声里的一条正值。特征要先有形成日之前就能知道的定义,再谈经济机制。一个种子上的正 R² 不够。 **D19.** 先不留。MDI 高只说明树在样本内爱用它。MDA 几乎不变,说明打乱这一列并不恶化损失,样本内的分裂没有换成样本外的误差。若线性贡献也挤在这一列的极端值上,更要怀疑是尖刺而不是稳定的预期收益。📌 章节知识总结
一句话核心洞察
-
个股月度样本外 R²,NN3 是 0.40%,全部变量 OLS 是 −3.46%,三变量 OLS 是 0.16%。分母是超额收益平方和。
-
价值加权十分位多空的夏普,NN4 是 1.35,NN3 是 1.20,三变量是 0.61。1.35 不是 NN3。
-
0.40% 开方再乘 √6000 得到 4.8990,那不是信息比率。
-
当期收益当特征,样本外 R² 是 1。滞后特征在种子 7 上是 0.009853,二十个种子平均是 −0.014408。
-
多空夏普要有空头腿。杠杆上限 1.0、只做多的账户对不上表 7。择时增益 0.26 不是夏普 0.26。
-
这四行上,岭回归两列都在,套索把第一列收成 0。清除重叠不等于已经做了禁运。
-
三栏教学路径上,主策略胜率 0.500000、期望 0.006875;元标签硬过滤后是 0.750000 和 0.025000。仓位停在 [0, 1],不产生空头。
公式与样本
| 对象 | 数值 | 前提 |
| --- | --- | --- |
| 样本 | 1957-03 至 2016-12,近 3 万只 | CRSP;含低价、非常规代码、金融股 |
| 样本外 | 1987–2016 | 不打乱 K 折 |
| 表 1,全样本 | OLS −3.46%,OLS-3 0.16%,NN3 0.40%,NN4 0.39% | 月度,百分数 |
| 表 1,NN3 | 最大 1,000 只 0.70%,最小 1,000 只 0.45% | 同一套估计 |
| 表 7,价值加权多空 | 0.6109、1.1980、1.3498 | 月均/月波动 × √12 |
| 等权 NN4 | 论文写 2.45;去掉小股票后 1.69 | 正文,不是本章重算 |
| 标普 500 择时 | 0.77 对 0.51,差 0.26 | NN3;表 6 是差 |
| 四期手算 | 0.533333 与 0.200000 | 误差平方和 0.000700 |
| 误用的上界 | 4.8990 | √0.004 × √6000 |
| 噪声 | 0.009853 与 1.000000 | 种子 7,240 期,至少 80 期 |
| 二十个种子 | 平均 −0.014408 | 只含滞后特征 |
| 标签重叠 | 留下 0、1、2、3 | 测试形成日 5 和 6,标签长 2 |
| NN4 最大回撤 | 51.78% | 表 8,价值加权多空 |
| NN4 持仓变动 | 126.81%/月 | 不是 M13 的 τ |
| 教学信噪比 | μ/σ = 0.05,方差比 0.0025 | μ = 0.005,σ = 0.10,不是 CRSP 估计 |
| 截面均值方差 | 独立情形的 20.8 倍 | N = 100,ρ = 0.2 |
| 岭回归 | −0.00048588,0.00324751 | 四行,λ = 0.1,已去均值 |
| 套索 | 0,0.00301963 | λ₁ = 0.01 |
| 弹性网 | 0,0.00301361 | λ₂ = 0.1 且 λ₁ = 0.01 |
| 一次分裂 | 平方和 0.0010 降到 0.0001 | 残差 0.02、0.01、−0.01、−0.02 |
| 打乱一列 | 误差增加 0.0000088268 与 0.0018821804 | 种子 7,基准 SSE 0.0000312858 |
| 禁运 | 清除后含 9;禁运 2 期后不含 9 | 12 个形成日,测试 6 和 7,标签长 2 |
| 表 1 网络深度 | 0.33、0.39、0.40、0.39、0.36 | 一至五层,百分数,论文给出 |
| 三栏止盈 / 止损 | 0.040000 / −0.020000 | σ = 0.02,k_pt = 2,k_sl = 1 |
| 竖直栏 | 0.005000 与 −0.010000 | 下标 10 与 35,元标签都是 0 |
| 主策略 | 胜率 0.500000,期望 0.006875 | 八笔都做 |
| 元标签硬过滤 | 胜率 0.750000,期望 0.025000 | 分数 ≥ 0.5 的四笔 |
| 按分数缩放 | 0.009437 | 0.0755/8 = 0.0094375,六位打印 |
| F₁ | 0.857143 | 精确率 0.750000,召回 1.000000 |
跨模块
| 结论 | 交给 | 位置 |
| --- | --- | --- |
| 0.40% 与 0.16% 的读法 | 低 R² 仍可能有组合差 | M00 |
| 时间顺序 | 特征停在形成日 | M03 |
| 4.8990 不是上界的正确输入 | 信息比率 | M09 |
| 量价信号的持有期 | 换手假设 | M10 |
| 126.81% 不能直接乘成本 | 单边换手 | M13 |
| 空头腿 | 杠杆上限 1.0 | ../../../docs/risk_policy.md |
| 预测进入订单 | 先落库 | M15 |
| 复算脚本 | 图 | ../figures/M16/plot_ml.py |
| 多次尝试之后还要不要做这笔多头 | 元标签只缩放仓位 | M08 |
学习指引
-
精读:Gu、Kelly 与 Xiu (2020) 的摘要、式 (19)、表 1 和表 7。先分清 R² 的列和夏普的列。
-
对照:夏普复算、四期 R² 和噪声路径以
figures/M16/plot_ml.py的打印为准。等权 2.45 和 1.69 是论文正文,本章没有从附录表再算一遍。 -
下一步:M17 把配置和择时放回只做多的约束里。机器学习的多空夏普不能越过那一章直接变成持仓。
自检清单
-
能说出 NN4 价值加权多空是 1.35,NN3 是 1.20,三变量是 0.61
-
能把 −3.46% 认成全部变量的个股 R²,而不是 0.61 的夏普
-
能把四期例子算成 0.533333 和 0.200000
-
能说明 4.8990 是误用基本定律的结果
-
能解释泄漏路径的 R² 为什么是 1.000000
-
能列出标签重叠后留下的形成日 0、1、2、3
-
能说明 0.26 是 0.77 减 0.51,以及空头腿在杠杆上限 1.0 下放不下
-
能把教学信噪比算成 0.05,并把 N = 100、ρ = 0.2 的方差倍数算成 20.8
-
能说出岭回归两列都在、套索第一列为 0,以及禁运 2 期会多删掉形成日 9
-
能区分 MDI 的样本内平方和下降、MDA 的打乱,以及线性贡献之和等于离差预测
-
能复述三栏教学路径的胜率 0.500000 对 0.750000、期望 0.006875 对 0.025000,以及 F₁ = 0.857143
-
能说明元标签的仓位落在 [0, 1],以及可选库没装上时的
sklearn_lgbm skipped不影响这组手算