M03 数据与回测工程
层级:L1 策略与回测 | 优先级:★★★ | 预计学时:12 小时 对应原书:陈 第 3 章;黑箱 第 8–9 章 前置知识:M01 的夏普与 t 值;M02 的
shift(1)。费用和冲击的形状在 M13。 读书笔记:陈第 3 章 · 黑箱第 8–9 章 状态:reviewed 数据截至:2026-09|最近复核:2026-10-28
学习目标
- 说出复权价、未复权价和总收益指数各用在哪一步,以及后来的分红为什么不能改写更早的点。
- 列出至少八种回测偏差,并指出本仓库引擎里哪一条规则挡住其中的三条。
- 用手算索提诺、卡玛和港股换手成本,分母和「单边」的定义与 M00 一致。
- 用同一条 SPY 均线量化前视:去掉延迟之后夏普从 0.51 变成 1.77。这是 bug,不是改进。
- 把样本外只用一次写成流程。
docs/workflow.md开头写明,本轮不把「夏普 > 1」当作通用门槛。 - 用停牌、上市天数、价格、20 日成交额和退市状态滤出可交易标的池,并把杠杆 ETF 与 PTP 预提名单挡在 ETF 轮动池外面。
本章知识拓扑图
flowchart TB
    RAW[未复权成交价] --> ORD[下单股数与整手]
    ACT[已发生的分红拆股] --> TR[向前累加的总收益指数]
    TR --> SIG[信号只看到当时已有的点]
    SIG --> SCH["as_of 收盘 / effective_at 下一交易日"]
    SCH --> FILL[先卖后买;停牌不成交]
    FILL --> FEE[费用表是输入,不是券商合同]
    FEE --> MET[CAGR 夏普 回撤 换手]
    MET --> LOG[实验日志:尝试次数与数据版本]
🟢 入门层:数据先分清用途
1. 三类数据,三种难度
| 类型 | 内容 | 个人投资者最先碰到的洞 |
|---|---|---|
| 量价 | 开高低收、成交量、分红拆股 | 免费接口通常没有已退市股票 |
| 基本面 | 财报、估值、一致预期 | 修订后的数字会覆盖当时还没公布的版本 |
| 另类 | 新闻、搜索、卫星、卡消费 | 贵,而且交付时间往往晚于广告 |
学习阶段够用的公开来源:yfinance(显式 auto_adjust=True)、Kenneth French 因子库、AQR 数据集、SEC EDGAR 的提交日期、FRED。富途 OpenAPI 和 IB 的历史请求能和交易打通,也有额度和退市缺口。含退市股的付费库是研究预算,不是回测脚本里的一个开关。
yfinance 不是交易所官方接口。它会失效,也不会因为你要做动量就自动补上退市公司。
2. 复权价不能拿来下单
三列价格是同一本日记的三种抄法,不能篡改已经写上的那一页。 未复权价是柜台当天的挂牌价,下单和整手用它。 前复权价为了让图连上最新价,每次新分红都倒回去改十年前的那一格,只适合看图。 向前总收益指数在分红当天把再投资滚进雪球,已经写下的历史点位不再改,排名和动量用这一列。
除息、拆股会让未复权价跳空,持有人的财富不一定变。前复权把历史价改到「看起来连着最新价」,适合看图,但每来一次新分红,整段历史都会重写。后复权和总收益指数把分红再投资往后累加,已经记下的点不再改。
本仓库 total_return_index 向前构造:每个点只用到当天及之前的公司行为。策略用它排名,避免把拆股看成暴跌。成交仍用未复权价。港股还要整手,腾讯是 100 股一手,用复权价算股数会下出交易所拒掉的数量。
3. 回测在回答哪一个问题
回测不是预测明年收益。它回答:这条写死的规则,在这段已知数据上,按你声明的成交和费用,净值怎么走。声明没写的东西(用了当天收盘、股票池是今天的成分、费用表不是你的账户)都会把答案抬高。M02 的 SPY 均线在正确时点下 CAGR 7.40%。本章把同一条规则的时点改错,用来看抬高了多少。
🟡 进阶层:偏差、指标和本仓库的成交
4. 十种偏差
| 偏差 | 当时不可能成立的假设 | 怎么挡住 |
|---|---|---|
| 前视 | 用 t 的收盘决定 t 的收益 | 收益乘 hₜ₋₁;引擎用下一交易日 effective_at |
| 幸存者 | 只用今天还上市的股票 | 股票池含退市;动量实验室的事后大市值池必须声明 |
| 时点 | 用尚未披露或后来修订的财报 | 用提交日;不知道披露日就滞后一个报告季 |
| 窥探 | 二百组参数只留下最好的一组 | 日志写尝试次数;M01 的 Bonferroni |
| 过拟合 | 参数只有一个点好看 | 邻域要一起报告,不要只报冠军 |
| 成本 | 按收盘价、零费用成交 | 费用表和价差写进回测;小账户算最低收费 |
| 流动性 | 想买多少就买多少 | 参与率用过去的成交量,不用当天收盘后的总量 |
| 做空 | 任何股票都能借到、费率为零 | 券源和借券费是输入;借不到就不要做空 |
| 公司行为 | 拆股当天触发止损 | 信号走总收益指数,下单走未复权价 |
| 基准 | 小盘规则去比标普 500 | 同池等权或因子回归,见 M14 |
还有一种隐蔽的窥探:2024 年的论文说某因子在 2010–2024 年有效,你再在 2010–2024 上回测。这段对你已经不是样本外。
5. 前视的数值:同一条均线
M02 的月末 10 个月均线,窗口 2014-11-30 至 2026-09-30,143 个月,现金收益 0,夏普扣年化 2% 再乘 √12。
红线不是更好的策略。它在月末已经知道自己高于均线,又把这个月已经实现的涨幅算进持仓。夏普从 0.51 抬到 1.77,CAGR 从 7.40% 抬到 21.28%。旧讲义里「从 0.5 虚高到 2 以上」是数量级上的警告;本样本的实测是 0.51 和 1.77,不要把 2 写成这次计算的结果。
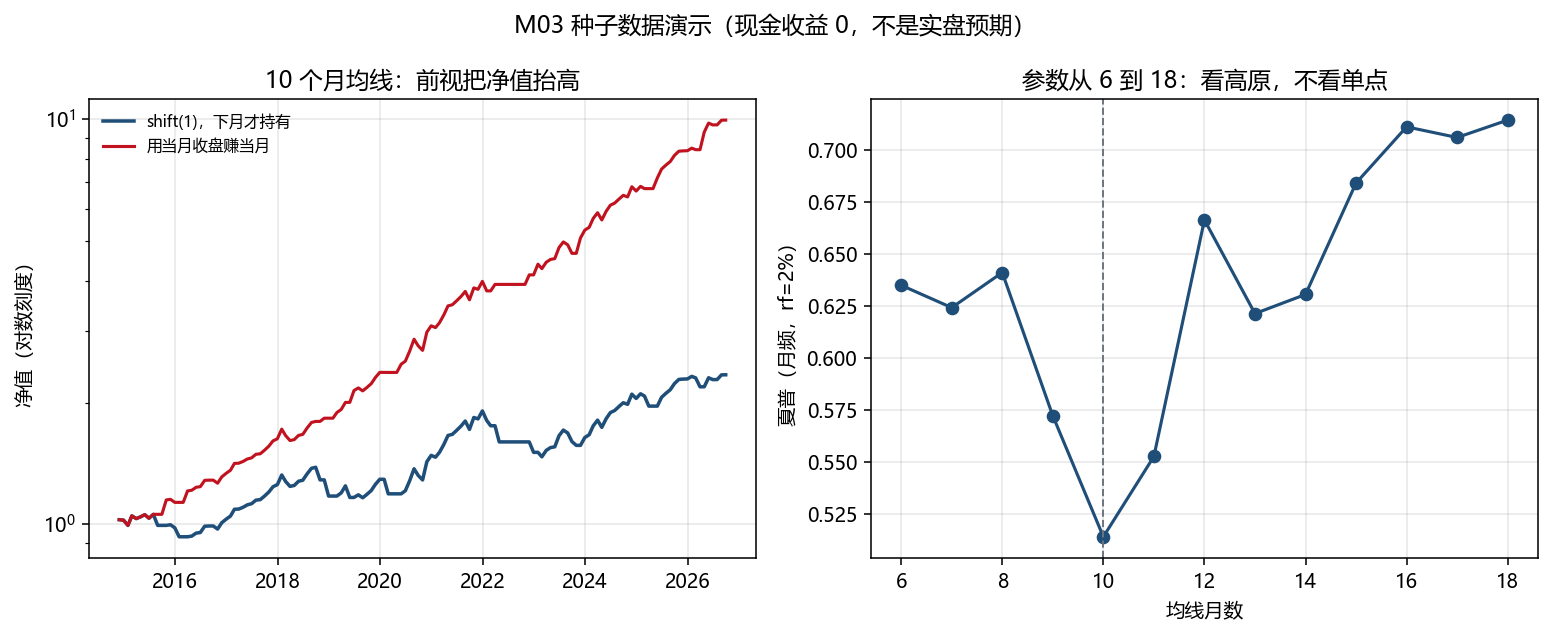
复现:uv run python knowledge/books/figures/M03/plot_lookahead.py。
右图是全样本敏感度,不是样本外。6 到 18 个月的夏普落在 0.51 到 0.71。10 个月是这组里的最低,18 个月是 0.71。没有一根针把夏普打到 2,所以它不是孤岛;它也不是平坦的高原。若因为 18 最高就只报告 18,你已经在同一段数据上挑过冠军,0.71 不能再叫样本外。
held = (month > sma).where(sma.notna())
honest = month.pct_change() * held.shift(1)
leaked = month.pct_change() * held  # 当月收盘同时决定当月收益
SmaCrossStrategy 内部不 shift。build_target_schedule 把信号标在收盘,把成交放到下一交易日。自己乘收益的脚本必须延迟;接进引擎后再延迟一次,会晚一个节拍。
6. 绩效公式
年化与夏普沿用 M01:日频用 √252,本章图是月频,用 √12,r_f 按 12 个月均摊。CAGR 用净值复利,不用算术平均冒充。
索提诺只把低于目标 T 的部分算进风险。本章手算用全部 n 个点做分母,目标以上的点贡献 0:
DD = √(1/n Σₜ₌₁ⁿ min(Rₜ − T, 0)²), Sortino = (¯R − T) / DD
有的软件只对低于目标的点求平均,或改用 n − 1。比较两个索提诺之前先对齐定义。Sortino & Price (1994, Journal of Investing 3(3)) 讨论的是下行偏差,不是「把亏损月的标准差再年化」这一种实现。
手算。 四期收益 3%, −2%, 4%, −1%,T = 0。
¯R = 0.01
DD = √((0 + 0.02² + 0 + 0.01²) / 4) = √0.000125 = 0.011180
Sortino = 0.01/0.011180 = 0.894
这是四期的比率,没有乘 √12。年化时分子和分母使用同一频率。
最大回撤沿用 M00:minₜ(Vₜ / max_(s≤t) Vₛ − 1)。卡玛比率:
Calmar = CAGR/|MDD|
手算。 CAGR 10%,最大回撤 −25%,卡玛 0.10/0.25 = 0.40。它把整段复利除以一次最深的坑,换窗口会跳。月末净值的回撤会漏掉月中的低点,M02 的 SPY 图已经是这个口径。
单边换手仍是成交额的一半除以净值。成本打在每一元成交上,所以拖累 = 2τ_单边c。
7. 换手成本
手算。 每月买入加卖出等于净值的 2 倍,即月单边换手 100%。每一元成交的费用加滑点为 0.2%。
年化拖累 = 12 × 2 × 0.002 = 4.8%
毛超额要先盖住 4.8%,再盖住回测乐观。盖住 4.8% 只说明成本项被抵消,不说明规则有样本外的正期望。
小账户的最低收费:
手算。 1 万美元,20 只股票,每只 500 美元,每月卖旧买新,每笔最低 2 美元。
20 × 2 × 12 × 2 = 960 美元 = 9.6%
改成 10 只、每季换一次:10 × 2 × 4 × 2 = 160 美元,占 1.6%。这里假设每次换仓都是一卖一买两笔,而且都触发最低收费。账户越小,持仓个数和换手越要先砍。
港股印花税仍是买卖各方 0.1%(2023-11-17 起,GovHK)。交易费、证监会征费、会财局征费以港交所现行收费表为准。教学上三者常被加总到大约 0.85 个基点(0.00565% + 0.0027% + 0.00015% = 0.0085%)。这个合计数会改,函数里要写成可替换的输入。
FeeSchedule 的文档写明:费率是输入,不是已经核对过的券商价目;个人所得税不在里面。label 必须说明它不是券商合同。压力测试只允许把费用乘以不小于 1 的倍数,避免「把成本调低来换夏普」。
8. 引擎里已经写死的三件事
src/quant/backtest/fills.py 把成交分成层,教学回测不要假装每一层都是实盘。
| 规则 | 代码里的含义 |
|---|---|
idealized |
按开盘价成交。注释写明这不是部署证据 |
limit |
开盘当中间价,让价不超过设定的基点;碰到最低价或最高价不算成交 |
| 参与率 | 用过去 20 个已完成交易日的成交量,不用当天最终成交量。历史不足 20 天就拒绝限价单 |
| 停牌 | 成交量为 0 的 K 线不是成交价 |
| 顺序 | 先卖后买。买进不能花掉一笔还没成交的卖出回款 |
这些规则挡住的是「用收盘总量证明自己当天买得进」和「停牌价被当成止损价」。它们不自动消除幸存者偏差,也不替你记录试了多少个参数。
9. 切分、滚动和这次均线搜索
固定切分:前面的年份开发,最后一段只碰一次。碰第二次,它就变成又一个训练集。
滚动前推:过去一段里挑选参数,下一段只使用,然后整窗往前移,把测试段接起来。挑选发生在测试段之前。
种子数据从 2014 年起,凑不齐「八年训练」。脚本用五年训练、下一日历年测试,参数仍是 6 到 18 个月。2020–2026 年共 81 个月:
| 年份 | 训练窗里夏普最高的月数 |
|---|---|
| 2020–2022 | 8 |
| 2023–2024 | 6 |
| 2025 | 12 |
| 2026(至 9 月,9 个月) | 15 |
接起来的 CAGR 11.19%,夏普 0.74。同一 81 个月里,买入持有 CAGR 15.32%、夏普 0.82;固定 10 个月均线 CAGR 9.20%、夏普 0.62。滚动选择好过死守 10 个月,仍然落后买入持有,而且冠军长度从 8 跳到 15。全样本上 18 个月的夏普 0.71 是另一段窗口,不能和 0.74 比高低。
docs/workflow.md 开头写明:本轮不使用「夏普 > 1」作为通用门槛;文中表格里的夏普 > 1 是历史参考。模拟观察至少三个日历月。回测纪律里已经有:信号只用当时已有的数据、成交用下一交易日、费用和借券入账、时间切分、记录尝试次数。
🔴 深入层:过拟合概率和重抽样
10. PBO 在数什么
Bailey, Borwein, López de Prado & Zhu (2017, Journal of Computational Finance 20(4)) 的组合对称交叉验证把时间切成若干块,枚举哪些块做训练。PBO 是「样本内最优参数,在对应测试块上的表现低于中位数」的比例。它回答的是选择过程有多容易挑中噪声,不是再给策略一个夏普。
本章的 13 个均线长度已经是一组多次尝试。即便右图没有孤峰,报告其中最大的 0.71 仍然用掉了一次选择。M01 的 Bonferroni 用的是次数;PBO 用的是「冠军在没见过的块上是否还排在前一半」。块太少时这个比例本身很噪,不能把某一次算出来的 PBO 当成精确概率。
Purged K-Fold 在训练集和测试集之间删掉标签重叠的样本,避免未来收益漏进训练。那是 M16 的题目。普通 K 折打乱日期,会把 t + 1 的收益分进训练集。
11. 块自助法给出的是分布
把日收益独立打乱会拆掉波动聚集。块自助法保留块内顺序(Künsch, 1989)。它回答:在这块历史的依赖结构下,夏普和最大回撤的区间有多宽。块长是参数,不写进日志就不能和别人的区间比较。M01 没有为 SPY 另报一个未声明块长的区间,本章也不补一个。
12. 可交易标的池
第 8 节的参与率挡住的是「用当天还没走完的成交量证明买得进」。标的池要在信号之前就做完同一类过滤,否则回测里的股票在发单当天本来就不该出现。实施计划(docs/post_tutorial_research_backtest_futu_plan.md) 第 7 节的流动性红线是:订单名义金额不超过过去 20 个已完成交易日平均成交额的 0.1%,历史不足 20 日就拒绝。src/quant/risk/gate.py 里的 ADV_WINDOW 也是 20。当天最终成交量不能拿来做下单前检查。
个股留在池子里,要同时满足四条。当日未停牌,并且上市满 N 天,教学例子取 N = 60。收盘价达到最低门槛:美股大于等于 5.0 美元,用来躲开仙股;港股大于等于 2.0 港元,用来躲开细价老千股。过去 20 个已完成交易日的平均成交额足够大,使这一笔订单不超过 0.1% × ADV。已经公告退市或处于特殊处理的,剔除。
手算:单笔订单 5,000 美元,是 10 万净值的 5%。参与率上限 0.1% 时,
5000/0.001 = 5000000
美元。过去 20 日平均成交额低于 5000000 美元的标的,这一笔就过不了红线。等于 5000000 时刚好落在上限上,可以留下。订单和 ADV 必须先换成同一种货币。
ETF 轮动池在这道流动性红线之外再加三条。剔除杠杆或反向 ETF,例如 TQQQ、SQQQ 和其他 3 倍工具。剔除要交 PTP 预提税的代码;USO、UNG、UVXY、SVXY、DBC 是常见例子,名单以券商当时的清单为准,规则本身见 M18 第 13 节。同一类暴露只留一只,教学规则是留下 20 日成交额更大的那只,成交额相同则留下代码字母序更靠前的一只,避免 SPY 和 VOO 同时占着美股大盘。
# goal2-check
"""可交易标的池。只读教学表,不访问行情网关。"""

from decimal import Decimal

import pandas as pd

LEVERAGED_NAMES = {"TQQQ", "SQQQ"}
PTP_NAMES = {"USO", "UNG", "UVXY", "SVXY", "DBC"}
PRICE_FLOOR = {"USD": Decimal("5.0"), "HKD": Decimal("2.0")}


def filter_tradable_universe(
    frame: pd.DataFrame,
    *,
    order_notional: Decimal,
    min_listed_days: int,
    max_participation: Decimal = Decimal("0.001"),
) -> pd.DataFrame:
    """个股四要素,ETF 再加杠杆/反向、PTP 和同类暴露。ADV 用已完成的 20 日。"""
    if order_notional <= 0 or max_participation <= 0 or min_listed_days < 0:
        raise ValueError("order, participation and listing age are out of range")
    # 5,000 / 0.001 = 5,000,000。Decimal 避免二进制浮点把门槛算少 1 美元。
    min_adv = order_notional / max_participation
    kept: list[dict[str, object]] = []
    for rec in frame.to_dict("records"):
        if rec["suspended"] or rec["delisting_or_st"] or int(rec["adv_days"]) < 20:
            continue
        if Decimal(str(rec["adv_20"])) < min_adv:
            continue
        kind = rec["kind"]
        if kind == "stock":
            floor = PRICE_FLOOR.get(str(rec["currency"]))
            if floor is None or Decimal(str(rec["close"])) < floor:
                continue
            if int(rec["listed_days"]) < min_listed_days:
                continue
            kept.append(rec)
        elif kind == "etf":
            symbol = str(rec["symbol"])
            # 标志列漏标时,教学黑名单仍挡住点名的杠杆 ETF 和 PTP。
            levered = bool(rec["leveraged_or_inverse"]) or symbol in LEVERAGED_NAMES
            ptp = bool(rec["ptp"]) or symbol in PTP_NAMES
            if levered or ptp:
                continue
            kept.append(rec)
    stocks = [rec for rec in kept if rec["kind"] == "stock"]
    etfs = [rec for rec in kept if rec["kind"] == "etf"]
    best: dict[str, dict[str, object]] = {}
    for rec in etfs:
        key = str(rec["exposure"])
        prev = best.get(key)
        if prev is None:
            best[key] = rec
            continue
        new_adv = Decimal(str(rec["adv_20"]))
        old_adv = Decimal(str(prev["adv_20"]))
        # 成交额更高者留下;相同则代码字母序更前者留下。
        if (new_adv, _invert(str(rec["symbol"]))) > (old_adv, _invert(str(prev["symbol"]))):
            best[key] = rec
    rows = stocks + list(best.values())
    out = pd.DataFrame(rows)
    if out.empty:
        return out
    return out.sort_values("symbol").reset_index(drop=True)


def _invert(symbol: str) -> str:
    """字母序靠前的代码,在「更大者胜」的比较里数值更大。"""
    return "".join(chr(255 - ord(ch)) for ch in symbol)


# 列:代码 种类 停牌 上市天数 收盘 币种 ADV20 已完成天数 退市 杠杆 反向/PTP 暴露
# 0/1 表示假/真。暴露用 - 表示空。SQQQ 的杠杆标志故意写成 0,靠名称黑名单剔除。
SPEC = [
    "AAPL stock 0 1000 180 USD 20000000 20 0 0 0 -",
    "PENNY stock 0 1000 4.99 USD 9000000 20 0 0 0 -",
    "HK1 stock 0 1000 1.99 HKD 9000000 20 0 0 0 -",
    "HK2 stock 0 400 2.0 HKD 5000000 20 0 0 0 -",
    "HALT stock 1 1000 20 USD 9000000 20 0 0 0 -",
    "YOUNG stock 0 59 20 USD 9000000 20 0 0 0 -",
    "THIN stock 0 100 20 USD 4999999 20 0 0 0 -",
    "LIQ stock 0 100 6 USD 5000000 20 0 0 0 -",
    "ST stock 0 1000 20 USD 9000000 20 1 0 0 -",
    "SHORT stock 0 1000 20 USD 9000000 19 0 0 0 -",
    "TQQQ etf 0 1000 50 USD 1000000000 20 0 1 0 ndx3",
    "USO etf 0 1000 70 USD 100000000 20 0 0 1 oil",
    "SPY etf 0 1000 500 USD 30000000000 20 0 0 0 us_large",
    "VOO etf 0 1000 500 USD 10000000000 20 0 0 0 us_large",
    "SQQQ etf 0 1000 20 USD 1000000000 20 0 0 0 ndx3",
]
FIELDS = [
    "symbol", "kind", "suspended", "listed_days", "close", "currency", "adv_20",
    "adv_days", "delisting_or_st", "leveraged_or_inverse", "ptp", "exposure",
]
BOOLS = {"suspended", "delisting_or_st", "leveraged_or_inverse", "ptp"}
INTS = {"listed_days", "adv_days"}


def _parse_spec(line: str) -> dict[str, object]:
    parts = line.split()
    row: dict[str, object] = {}
    for name, raw in zip(FIELDS, parts, strict=True):
        if name in BOOLS:
            row[name] = raw == "1"
        elif name in INTS:
            row[name] = int(raw)
        elif name == "exposure" and raw == "-":
            row[name] = ""
        else:
            row[name] = raw
    return row


sample = pd.DataFrame([_parse_spec(line) for line in SPEC])
universe = filter_tradable_universe(
    sample,
    order_notional=Decimal("5000"),
    min_listed_days=60,
)
print("min_adv", int(Decimal("5000") / Decimal("0.001")))
print("kept", ",".join(universe["symbol"].tolist()))
assert int(Decimal("5000") / Decimal("0.001")) == 5000000
assert universe["symbol"].tolist() == ["AAPL", "HK2", "LIQ", "SPY"]
SQQQ 的标志列故意留成假,教学黑名单仍要把它剔除。SPY 与 VOO 同类,留下成交额更大的 SPY。THIN 的平均成交额是 4999999 美元,进不了池。
13. 本仓库研究数据与冻结快照工作流
研究数据不进 Git。目录是 data/processed/snapshots、data/processed/intraday、data/raw、data/cache、data/probe。多台开发机之间以 VPS 为中转,不在每台机器上各下一份同名文件。
冻结靠 SHA-256。快照注册之后,本机文件的哈希必须和注册记录一致。重新下载一份同名 Parquet,字节一变,哈希就变,回测不再是已经报告过的那一份样本。禁止用临时下载的同名文件去替换已注册快照。
三条命令分工,都在仓库根目录执行。用之前先取:uv run python scripts/ops/vps.py pull-research。本机已经和 VPS 一致时,这条会跳过。本机确认无误的新快照用 uv run python -m quant.cli data snapshot 生成;AGENTS.md 里的简写是 quant.cli data snapshot。生成并核对之后再发布:uv run python scripts/ops/vps.py push-research。VPS 上有本机没有的研究文件时,先拉再推。--force 会丢掉别的机器已经发布的数据,不能当成日常同步。
开发机没有接入 VPS 时,先按 deploy/README.md 做 vps.py init 和 vps.py enroll。这条链路只搬研究文件。它不连接 OpenD,也不写 ledger.db。
真实案例
案例 1:事后成分把基准抬高
动量实验室用今天的大市值名单回放 2008 年以后。等权基准的 CAGR 是 21.79%,策略 Iter 5 是 29.96%。实验室 README 把 21.79% 归因于幸存者偏差和事后入选,并要求只读相对同池的超额。Elton, Gruber & Blake (1996, RFS 9(4)) 估计的是共同基金数据库的幸存者偏差,大约每年 0.9 个百分点。那是基金样本的数字,不能挪来当成「个股动量每年因此虚高 0.9%」。个股偏差的本地证据就是这个 21.79% 的同池基准,而不是一个通用加成。
案例 2:发表后变薄,不是打五折的公式
McLean & Pontiff (2016, JF 71(1)):97 个预测变量,样本外平均低 26%,发表后平均低 58%。26% 是数据挖掘效应的上界,因为发表前已有人在交易。发表本身大约再解释 32 个百分点。旧讲义里的「回测收益打五折」容易被当成操作规则。论文的 58% 是这 97 个组合的平均降幅,不是你下一次回测应该乘的系数。用法是:预期更薄,把成本假设提高,并停止在同一段样本上继续搜。
案例 3:前视把 0.51 做成 1.77
见第 5 节的表。修正是 shift(1),或者把成交交给引擎的下一交易日。项目里的均线夹具走第二条路,路径是 src/quant/strategies/examples/sma_cross.py,不是旧讲义写的 src/quant/strategies/sma_cross.py。
方法论来源
| 概念 | 出处 |
|---|---|
| 研究流程 | Narang 第 8–9 章;Chan 第 3 章 |
| 索提诺 | Sortino & Price (1994), Journal of Investing 3(3) |
| 基金幸存者偏差 | Elton, Gruber & Blake (1996), RFS 9(4) |
| 发表后衰减 | McLean & Pontiff (2016), JF 71(1) |
| PBO | Bailey 等 (2017), Journal of Computational Finance 20(4) |
| 块自助 | Künsch (1989), The Annals of Statistics 17(4) |
| 本仓库成交 | src/quant/backtest/fills.py、fees.py、data/corporate_actions.py |
| 本仓库绩效 | src/quant/backtest/metrics.py |
| 流程门槛 | docs/workflow.md 开头:本轮不以夏普 > 1 为通用门槛 |
| ## 💡 思考回顾与巩固 |
核心认知纠偏
| 误区 | 反例 | 用法 |
|---|---|---|
| 前复权价可以用来算股数 | 新分红会重写历史价;港股还有整手 | 排名用向前的总收益指数,下单用未复权价 |
去掉 shift(1) 夏普变好,说明规则更强 |
同一条均线从 0.51 变成 1.77 | 那是用当月收盘赚当月 |
| 全样本里 18 个月夏普最高,就是样本外最优 | 右图用了全部 143 个月。滚动选择的长度从 8 跳到 15 | 冠军参数和测试段不能是同一段 |
| 回测收益统一打五折 | 58% 是 97 个已发表预测变量的平均降幅 | 提高成本、停止续搜,不要乘一个万能系数 |
| 当天成交量可以证明限价单能成交 | 引擎的参与率只用过去 20 日,当天总量还没走完 | 历史不足 20 日就拒绝 |
| 池子里的股票只要有价格就能买 | 5,000 美元、参与率 0.1% 要求 20 日均成交额至少 5000000 美元 | 停牌、上市天数、价格和退市状态同时过关 |
| 夏普 > 1 是本项目当前门槛 | docs/workflow.md 开头写明本轮不这么用 |
以文件开头的句子为准,不以后面的历史表为准 |
| 基金论文里每年 0.9% 的幸存者偏差适用于个股动量 | 0.9 个百分点是 Elton 等人的基金样本 | 个股用同池事后基准来说明,如 21.79% |
费曼自测
- 为什么总收益指数必须向前累加?
- 前视那条红线的 21.28% 能不能当作策略上限?
- 滚动前推的 0.74 为什么不能和全样本 18 个月的 0.71 比?
- 一笔还没成交的卖出,为什么不能把回款用来买?
自测要点
1. 向后调整会在新的分红到达时改写旧价格。信号若用改写后的历史,就用到了当时不存在的公司行为。向前累加只让新的点包含新的分红。 2. 不能。21.28% 把「月末才知道的均线位置」乘进了已经结束的这个月。它是错误实现的净值。 3. 0.71 用了 2014–2026 全部月份来挑 18。0.74 只覆盖 2020–2026 的 81 个月,而且每年的长度是在那一年之前选定的。窗口不同,夏普不能直接排名。同一 81 个月上,买入持有的夏普是 0.82。 4. 卖出可能不成交,尤其是限价和停牌。先把未成交的现金算进购买力,会在回测里造出实盘没有的买入。引擎因此先处理卖出。四维习题
A. 概念题
- 列出八种回测偏差,每种写一条检测动作。
- 为什么样本外段只能用一次?用过两次之后它变成什么?
- 前复权和向前的总收益指数各适合什么?下单用哪一个价格?
idealized成交为什么不能当作部署证据?
B. 计算题
- 四期收益 3%, −2%, 4%, −1%,目标为 0。按本章分母为 n 的定义计算索提诺。若只对两个负收益求均方根,比率变成多少?
- CAGR 10%,最大回撤 −25%。卡玛比率是多少?若回撤改用月中低点、从 −25% 加深到 −40%,卡玛变成多少?
- 每月双边成交额为净值的 2 倍,每元成交成本 0.2%。年化成本拖累是多少?
- 账户 1 万美元。方案甲:20 只股票、每月一卖一买、每笔 2 美元。方案乙:10 只、每季一卖一买、每笔 2 美元。年化成本占账户的比例各是多少?
C. 编程实战题
- 用 SPY 种子复现 10 个月均线的两条净值:
shift(1)与不延迟。打印两边的 CAGR 和夏普(r_f = 2%,月频 √12)。 - 对长度 6 到 18 计算全样本夏普,指出最低和最高的长度。说明这张图为什么还不是样本外。
- 用五年训练、下一年测试,把 2020–2026 接起来,并与同一月份上的买入持有、固定 10 个月比较。
D. 个人实战思考题
- 你要用 yfinance 做美股小盘动量。列出数据上的三项偏差,以及你能量化或至少声明的方式。
- 对照
docs/workflow.md,写十条回测检查。其中四条必须来自本仓库引擎已经实现的约束,而不是泛泛的「考虑成本」。 - 小账户 1 万美元、月换 20 只的成本占 9.6%。你的真实最低收费若不是 2 美元,这项比例会怎样改变你的持仓个数?
完整参考答案与解析
**A1.** 前视:收益是否乘了上一期信号。幸存者:股票池是否包含退市和当时的成分。时点:财报用的是提交日还是报表期。窥探:日志里的尝试次数是否包括删掉的参数。过拟合:邻域参数是否一起报告。成本:费用表是否单列最低收费和印花税。流动性:参与率是否用过去成交量。做空:借不到的股票是否仍被假设为空头。公司行为:拆股是否走总收益指数。基准:比较对象是否和股票池匹配。上面十条里任取八条即可,检测动作必须能在脚本或日志里指出来。 **A2.** 样本外的意义是挑选规则时没有看过它。看过一次并据此改参数,第二次的结果就含着这次修改。它变成新的训练集。真正没碰过的只剩之后的模拟盘和实盘。 **A3.** 前复权适合看连续的价格图,历史会被新的公司行为改写。向前的总收益指数适合算收益和排名。下单用未复权价,再按手数取整。 **A4.** `idealized` 按开盘价成交,不检查能否在量内成交,也不检查停牌。文件注释写明它不是部署证据。部署要看限价、过去成交量和费用表。 **B5.** 均值 0.01。四个点的下行平方和是 0.0004 + 0.0001 = 0.0005,除以 4 再开方得 0.011180,索提诺 0.894。只对两个负值:√(0.0005/2) = 0.015811,比率 0.01/0.015811 = 0.632。两个都对,只要写明分母。本章正文用 0.894 这一档。 **B6.** 0.10/0.25 = 0.40。加深后 0.10/0.40 = 0.25。月末回撤漏掉月中低点时,卡玛会被抬高。 **B7.** 月单边换手 = 2/2 = 1。年化拖累 = 12 × 2 × 0.002 = 0.048。等价地,每月成交额是净值的 2 倍,乘 0.2% 再乘 12。 **B8.** 甲:20 × 2 × 12 × 2 = 960 美元,占 9.6%。乙:10 × 2 × 4 × 2 = 160 美元,占 1.6%。这是最低收费触发时的上限结构。若佣金按金额、低于最低收费的门槛没被触发,比例会更低;小名义金额通常会触发。 **C9–C11.** 与 `plot_lookahead.py` 同一契约。延迟:CAGR 7.40%,夏普 0.51。前视:CAGR 21.28%,夏普 1.77。全样本夏普最低是 10 个月(0.51),最高是 18 个月(0.71)。这张扫描使用了全部月份,所以最高点不是样本外。五年训练的滚动结果:2020–2022 选 8,2023–2024 选 6,2025 选 12,2026 选 15。接起来 CAGR 11.19%、夏普 0.74(81 个月)。同一段买入持有 15.32% 与 0.82,固定 10 个月 9.20% 与 0.62。import math
from pathlib import Path
import pandas as pd
RF = 0.02
px = pd.read_csv(
Path("knowledge/Labs/momentum_plus_lab/seed_data/spy.csv"),
parse_dates=["session"],
).set_index("session")["adj_close"].astype(float).sort_index()
month = px.resample("ME").last().dropna()
def sharpe(ret: pd.Series) -> float:
std = float(ret.std(ddof=1))
excess = float(ret.mean()) - RF / 12.0
return excess / std * math.sqrt(12.0)
def cagr(ret: pd.Series) -> float:
years = len(ret) / 12.0
return float((1.0 + ret).prod() ** (1.0 / years) - 1.0)
def run(window: int, delay: bool) -> pd.Series:
sma = month.rolling(window).mean()
held = (month > sma).where(sma.notna())
if delay:
held = held.shift(1)
frame = pd.concat({"mkt": month.pct_change(), "held": held}, axis=1).dropna()
return frame["mkt"] * frame["held"].astype(float)
ok, leak = run(10, True), run(10, False)
common = pd.concat({"ok": ok, "leak": leak}, axis=1).dropna()
print("honest", round(cagr(common["ok"]), 4), round(sharpe(common["ok"]), 2))
print("leaked", round(cagr(common["leak"]), 4), round(sharpe(common["leak"]), 2))
📌 章节知识总结
一句话核心洞察
- 排名用向前的总收益指数,下单用未复权价。新的分红不能改写旧的信号。
- 同一条 10 个月均线,前视把夏普从 0.51 抬到 1.77。红线不是业绩。
- 全样本冠军和滚动测试的夏普不能跨窗口比较。这次滚动仍然跑输买入持有。
- 成本打在每一元成交上。月双边 2 倍净值、每元 0.2%,一年是 4.8%。1 万美元月换 20 只、每笔 2 美元,是 9.6%。
- 发表后平均下降 58% 是那 97 个预测变量的结果,不是一个可以乘到任何回测上的系数。
公式与参数速查
| 名称 | 表达式或数值 | 前提 |
|---|---|---|
| 诚实均线 | Rₜ hₜ₋₁ | 均线不足时保持缺失 |
| 本章前视对照 | 夏普 1.77 对 0.51;CAGR 21.28% 对 7.40% | 2014-11 至 2026-09,现金收益 0,r_f = 2% |
| 长度 6–18 | 夏普 0.51–0.71;10 个月最低,18 个月 0.71 | 全样本,不是样本外 |
| 五年滚动 | 接起 CAGR 11.19%,夏普 0.74 | 2020–2026 共 81 个月;同期买入持有夏普 0.82 |
| 索提诺手算 | 0.01/0.011180 = 0.894 | 分母含全部 n 点;未年化 |
| 卡玛 | CAGR/|MDD| |
10% 与 25% 时为 0.40 |
| 换手拖累 | 2τ_单边c |
月单边换手 1、c = 0.2% 时为 4.8%/年 |
| 小账户 | 20 只月换、每笔 2 美元 → 9.6% | 1 万美元;每笔都触发最低收费 |
| 港股印花税 | 买卖各方 0.1% | 2023-11-17 起 |
| 参与率回看 | 20 个已完成交易日 | ADV_LOOKBACK;不用当天总量 |
| 单笔 5,000 美元的 ADV 门槛 | 5000000 美元 | 5000/0.001;10 万净值的 5%,参与率 0.1% |
| 价格门槛 | 美股 ≥ 5.0 美元,港股 ≥ 2.0 港元 | 个股池;ETF 另剔杠杆/反向和 PTP |
| 基金幸存者偏差 | 约每年 0.9 个百分点 | Elton 等的基金样本,不是个股公式 |
跨模块联结
| 本章结论 | 下游 | 工程落点 |
|---|---|---|
| 时点与前视 | M02 的均线、M06 的因子 | src/quant/core/signals.py |
| 总收益指数向前构造 | 排名与复权 | src/quant/data/corporate_actions.py |
| 费用是输入 | M13 | src/quant/backtest/fees.py |
| 成交约束 | M15 的模拟盘 | src/quant/backtest/fills.py |
| 可交易标的池 | 发单前的流动性与 PTP | src/quant/risk/gate.py 的 ADV_WINDOW;M18 |
| 尝试次数 | M08 | docs/workflow.md |
| 事后股票池 | 读实验室时先读声明 | knowledge/Labs/momentum_lab/README.md 第五节 |
学习指引
概念卡片:前视偏差与幸存者偏差
- 对照原书:陈第 3 章笔记 看陷阱清单在书里的位置;黑箱第 8–9 章笔记 看数据和科学流程怎样映射到实验目录。
- 项目:
docs/workflow.md的开头句子优先于后表里的夏普门槛。 - 下一步:M04 资金管理与风险控制。回撤和杠杆要用本章的口径,不要用前视净值去标定风险预算。
自检清单
- 能解释 0.51 与 1.77 的差别来自时点,不来自参数
- 能手算索提诺 0.894 和年化成本 4.8%
- 能说出参与率为什么不用当天成交量
- 能说明滚动夏普 0.74 与全样本 0.71 不能比
- 知道本轮流程不以夏普 > 1 为门槛
- 下单价和排名价在笔记里分成两列