M01 数理统计工具箱
层级:L0 入门与全景 | 优先级:★★★(按需查阅)| 预计学时:首轮 8 小时,之后随模块回查 对应原书:GK 附录 C;因子 2.2、2.4.3、2.6;陈 7.3 前置知识:M00 的夏普与 √252 约定。因子回归的经济含义在 M05 和 M06。 读书笔记:GK 附录 C · 因子第 2 章推断 状态:reviewed 数据截至:2026-09|最近复核:2026-10-22
学习目标
- 用同一套定义计算简单收益、对数收益、CAGR、年化波动和夏普,并指出定义换了之后哪个数会变。
- 用手算完成一个五天样本的偏度,以及一个四点样本的 OLS 斜率。
- 把「t ≈ 年化夏普 × √年数」推导到和
src/quant/backtest/metrics.py的夏普一致,并把它和 Lo (2002) 的夏普标准误分开。 - 说明一次检验的 p 值、试了 50 次之后的 Bonferroni 门槛、Newey–West 标准误各自在防什么。
- 用实验室种子数据说出:正态参照会把日跌 5% 的次数低估多少,以及一元回归的 t 值在 HAC 之后如何变化。
本章知识拓扑图
M01 不生产交易信号。它规定后面每一章在说「显著」「年化」「相关」时用的是哪一个估计量。
flowchart TB
    P[复权价格] --> R[简单收益 / 对数收益]
    R --> D[均值 波动 偏度 峰度]
    D --> SR[夏普]
    SR --> T[t ≈ SR × √年数]
    R --> REG[OLS:α β R²]
    REG --> SE[普通标准误]
    REG --> HAC[Newey–West]
    SE --> MT[多重检验门槛]
    HAC --> MT
    R --> TS[自相关 平稳 协整]
    D --> TAIL[肥尾:回撤与 CVaR 交给 M04]
    REG --> FAC[时序回归交给 M06]
    TS --> PAIR[配对交易交给 M02]
🟢 入门层:直觉与第一性原理
统计量是压缩。把两千个日收益压成一个夏普之后,信息会丢掉,丢掉的部分往往就是亏损的形状。本章的习惯是:先写清估计量的公式,再问这个公式假定了什么独立性,最后才看一个数大不大。
1. 两种收益率,对应两种加法
简单收益回答「这一期账户变了几个百分点」。对数收益回答「把很多期的变化连加,是否还等于整段的变化」。
| 简单收益 Rₜ | 对数收益 rₜ = ln(1 + Rₜ) | |
|---|---|---|
| 跨资产 | 组合收益是成分简单收益的加权和 | 加权对数收益不是组合的对数收益 |
| 跨时间 | 必须连乘 (1 + R₁)(1 + R₂) − 1 | 可以直接相加 |
| 价格小幅波动 | 两者几乎相同 | 两者几乎相同 |
| 单日 ±20% | 必须用简单收益记净值 | 对数收益仍可加,但百分比含义差一截 |
个人账户里最常见的两处用错:
- 未复权价格把分红和拆股记成暴跌。yfinance 要写
auto_adjust=True。本仓库实验室种子里的adj_close已经是复权价。 - 用对数收益按权重合成组合。组合净值的日变化是简单收益的加权和,权重要用前一日收盘后的权重。
2. 年化是在声明独立性
日波动乘 √252,是因为「若日收益互不相关,方差可以相加,标准差按根号相加」。美股常规年份大约 252 个交易时段。港股一年的交易日通常少一些,年化港股日收益时用该序列实际覆盖的交易日,不要把 252 当成物理常数。月频收益年化波动用 √12,不能和日频的 √252 乘在同一步里。
正自相关(趋势连着趋势)时,按独立假设年化会低估长期波动。负自相关(涨了容易回吐)时,独立假设会高估长期波动。后面的种子数据里,SPY 日收益的一阶自相关是负的,所以 √252 在这个样本上偏乐观地放大了波动。方向在这里说清,修正公式在进阶层,不把某一个修正值写成「真正的波动率」。
3. 夏普是超额收益的斜率,不是财富增长率
夏普把平均超额收益除以波动。它不回答「一年后账户多了多少」,那是 CAGR 的工作。无风险利率在 2010 年代可以近似成 0,2023 年以后美元短债利率回到 4% 以上,再把总收益除以波动,会把现金利率算进策略。本仓库的定义见 M00,和 metrics.py 相同:先减日无风险利率,再用样本标准差,最后乘 √252。
夏普的高低要和窗口、无风险利率一起读。回测夏普超过 2 的低频规则,先检查前视、幸存者和成本(M03),而不是先加杠杆。
4. 钟形分布盖不住股票的单日
偏度看左右是否对称。股票日收益常常左偏:小涨的日子多,大跌的日子少但很深。峰度看尾巴比钟形厚多少。正态的 Pearson 峰度是 3。卖波动率的账户通常左偏又厚尾,平时小赚、偶发大亏;趋势跟踪有机会右偏,很多小亏换少数大赚。这两种账户的夏普可以接近,最大回撤完全不同。M04 因此不只看波动。
相关是线性的共同变动,范围在 −1 到 1。危机里相关会升高,平时算出来的分散会在同一周消失。相关高也不表示价差会回到某个中枢。价差能否回归,问的是协整,不是相关系数。
🟡 进阶层:公式、手算与可复现计算
本节矩估计一律先用「除以 n」的中心矩,方便手算。软件里的调整系数在符号表下面单独写。不要把两种峰度当成同一个数。
5. 简单收益、对数收益与复利
Rₜ = Pₜ/Pₜ₋₁ − 1, rₜ = ln(1 + Rₜ), R_(0→T) = ∏ₜ₌₁ᵀ(1 + Rₜ) − 1
| 符号 | 含义 |
|---|---|
| Pₜ | 第 t 日复权价格 |
| Rₜ | 简单收益 |
| rₜ | 对数收益 |
推导:ln(P_T/P₀) = Σₜ₌₁ᵀ ln(Pₜ/Pₜ₋₁) = Σ rₜ。指数回去得到 P_T/P₀ − 1 = exp(Σ rₜ) − 1,这和连乘简单收益是同一段财富。
手算。 连续两天 +10%、−10%。
R = 1.10 × 0.90 − 1 = −1%
r = ln 1.10 + ln 0.90 = ln 0.99 = −0.0100503
exp(−0.0100503) − 1 = −1%
对数收益加总再指数化,回到同一个 −1%。单看对数收益的 −1.005%,会比账户亏损多报 0.005 个百分点。再看一个大跳跃:+50% 的对数收益是 ln 1.5 = 0.405465,约 40.55%,和简单收益差将近 10 个百分点。
6. 年化波动、自相关与 √252
s = √(1 / (n − 1) Σₜ₌₁ⁿ(Rₜ − ¯R)²), σ_iid = s √N
N 是要放大的期数:日收益放到一年用 252,月收益用 12。
若日收益还有自相关 ρⱼ,多期方差不再是 N 倍日方差。只保留一阶、并且 |ρ₁| 不大时,常用近似是:
σ_adj ≈ s √N √(1 + 2ρ₁)
这是 Lo (2002, Financial Analysts Journal 58(4)) 讨论年化夏普时的同一类修正。更高阶自相关不为零时,根号里要换成 1 + 2 Σⱼ₌₁^k(1 − j/N) ρⱼ。本章的种子数据只报告 ρ₁,不把近似式的输出写成修正后的官方波动。
手算。 日标准差 1%,ρ₁ = 0,N = 252:
σ_iid = 0.01 × √252 = 0.01 × 15.8745 = 15.8745%
若 ρ₁ = −0.10:
√(1 + 2 × (−0.10)) = √0.80 = 0.8944
σ_adj ≈ 15.8745% × 0.8944 = 14.20%
负自相关把长期波动降下来。用独立假设去设止损,止损会比真实的周波动更宽。
7. 偏度与峰度
除以 n 的中心矩:
mₖ = 1/n Σₜ₌₁ⁿ(Rₜ − ¯R)^k, Skew = m₃ / (m₂^(3/2)), Kurt = m₄/m₂²
| 符号 | 正态参照 | 软件里容易混的名字 |
|---|---|---|
| Skew | 0 | pandas.Series.skew 还会乘 √(n(n − 1)) / (n − 2),大样本才和 m₃ / m₂^(3/2) 几乎相同 |
| Kurt | 3 | 这是 Pearson 峰度。pandas.Series.kurt 默认是超额峰度,正态参照是 0 |
手算。 五日简单收益 −4%, −1%, 0, +1%, +2%。
¯R = (−0.04 − 0.01 + 0 + 0.01 + 0.02) / 5 = −0.004
离差:−0.036, −0.006, 0.004, 0.014, 0.024。
m₂ = (0.036² + 0.006² + 0.004² + 0.014² + 0.024²) / 5 = 0.000424
m₃ = ((−0.036)³ + (−0.006)³ + 0.004³ + 0.014³ + 0.024³) / 5 = −6.048 × 10⁻⁶
Skew = (−6.048 × 10⁻⁶) / (0.000424^(1.5)) = −0.693
左偏来自那一个 −4% 的日子。同一组数的 Pearson 峰度只有 2.28,低于正态的 3。五点样本里的一次下跌,不够把四阶矩抬过钟形。肥尾要用长样本看,不能靠一个故事。
8. 从日超额到 t 值
与 M00、metrics.py 相同的年化夏普:
SR = (¯R − r_f/252) / s × √252
日超额均值的经典 t 统计量(独立同分布、标准误 s/√n)是:
t = ((¯R − r_f/252) / (s/√n)) = (((¯R − r_f/252) / s) √n) = SR × √(n/252)
最后一步因为 SR 里已经乘过 √252,而 n/252 就是这段样本的年数 Y。所以:
t = SR × √Y
这是「均值是否为 0」的 t,波动用样本标准差,但标准误公式仍假设日收益独立。它不是 Lo 给夏普估计量本身准备的标准误。两者在第 12 节分开。
手算。 年化夏普 0.8。
t = 2 ⇒ Y = (2/0.8)² = 6.25 年
t = 3 ⇒ Y = (3/0.8)² = 14.0625 年
三年回测、夏普 1.5:t = 1.5 √3 = 2.598。二十年、夏普 0.6:t = 0.6 √20 = 2.683。证据强度接近,但二十年跨过更多制度,M08 会把这一点放进先验,而不是只比 t。
9. 四点样本的 OLS
一元回归,带截距:
yₜ = α + β xₜ + εₜ
斜率是中心化之后的最小二乘:
ˆβ = (Σₜ(xₜ − ¯x)(yₜ − ¯y)) / (Σₜ(xₜ − ¯x)²), ˆα = ¯y − ˆβ¯x
残差方差用自由度 n − 2:
s² = 1 / (n − 2) Σₜ ˆεₜ², SE(ˆβ) = s / √(Σₜ(xₜ − ¯x)²)
t_β = ˆβ / SE(ˆβ)
几何上,OLS 把 y 投到 (1, x) 张成的平面,残差和这两列都正交。M06 的因子正交化用的是同一件事:先把一个因子对另一个因子回归,再取残差。
手算。 x 为市场超额,y 为资产超额,四个点:
| t | x | y |
|---|---|---|
| 1 | 0.01 | 0.015 |
| 2 | −0.02 | −0.018 |
| 3 | 0.02 | 0.030 |
| 4 | 0.00 | −0.004 |
¯x = 0.0025, ¯y = 0.00575
中心化后的交叉乘积之和是 0.0010525,x 的离差平方和是 0.000875。
ˆβ = 0.0010525/0.000875 = 1.20286
ˆα = 0.00575 − 1.20286 × 0.0025 = 0.002743
脚本给出 t_β = 6.16、R² = 0.950、自由度 2。自由度为 2 时,双侧 5% 的 t 临界值约 4.30,不是 1.96。这个 R² 只说明四个点几乎共线,不能外推到下一周。
下面的片段复现第 7 节和第 9 节。数字已与脚本输出对照。
import math

import numpy as np

toy = np.array([-0.04, -0.01, 0.00, 0.01, 0.02])
center = toy - toy.mean()
m2 = np.mean(center**2)
skew = np.mean(center**3) / m2**1.5
print(round(float(toy.mean()), 3), round(float(skew), 3))  # -0.004  -0.693

x = np.array([0.01, -0.02, 0.02, 0.00])
y = np.array([0.015, -0.018, 0.030, -0.004])
design = np.column_stack([np.ones(len(x)), x])
alpha, beta = np.linalg.lstsq(design, y, rcond=None)[0]
print(round(float(alpha), 6), round(float(beta), 5))  # 0.002743  1.20286
print(round(math.log(1.5), 6))  # 0.405465
10. 种子数据上的分布与一元回归
图和数字来自 knowledge/Labs/momentum_plus_lab/seed_data/ 的复权收盘价,窗口 2014-01-03 至 2026-09-28,共 3202 个日收益。复现:
uv run python knowledge/books/figures/M01/plot_returns_and_capm.py
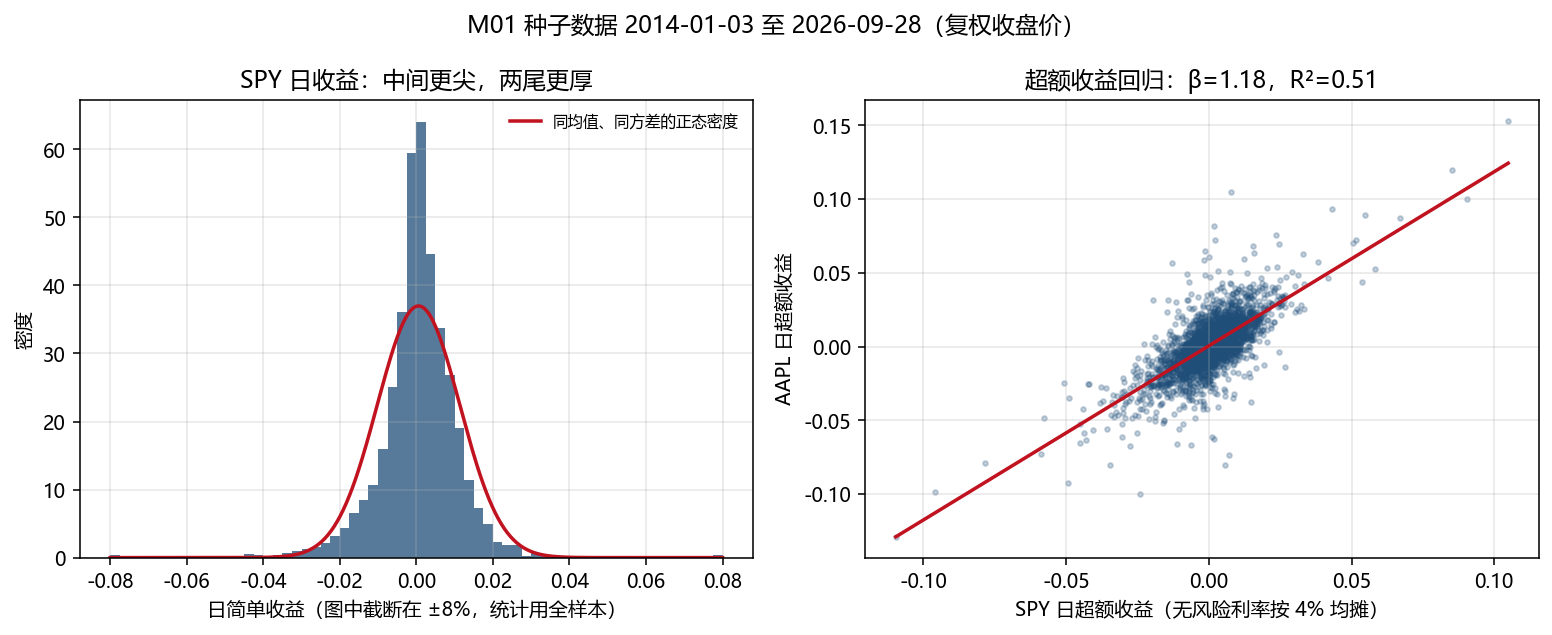
SPY 日简单收益(总收益,不扣无风险利率):
| 统计量 | 数值 | 读法 |
|---|---|---|
| 日均 | 0.000572 | 算术平均,不是 CAGR |
| 日标准差 | 0.01079 | 样本标准差,分母 n − 1 |
| 按独立假设的年化波动 | 17.12% | 0.01079 × √252 |
| 一阶自相关 | −0.114 | √252 会高估这段样本的长期波动 |
| 矩偏度 | −0.311 | 左偏 |
| Pearson 峰度 | 17.39 | 正态是 3;超额峰度 14.39 |
| 日收益 ≤ −3% | 35 天 | 同均值同方差的正态参照约 7.4 天 |
| 日收益 ≤ −5% | 6 天 | 正态参照约 0.004 天 |
2020-03-16,该 SPY 序列相对前一交易日的收益是 −10.94%(312.61 / 351.02 − 1)。2019 年同一序列的日标准差是 0.788%,年化 12.51%。按 2019 年的波动,这一天是 −13.9 个标准差。这是 ETF 复权收盘价,不是标普 500 价格指数的官方日涨跌;两条序列不要加在一起引用。
右图的回归把两边都减去 0.04/252,得到日超额。斜率对「两边减去同一个常数」不变。
| OLS | Newey–West,L = 8 | |
|---|---|---|
| ˆβ | 1.181 | 点估计相同,标准误不同 |
| ˆα(每日) | 0.000443 | 同上 |
| t(ˆβ) | 58.12 | 40.55 |
| t(ˆα) | 2.021 | 1.956 |
| R² | 0.513 | 不因标准误而改变 |
L = ⌊4(T/100)^(2/9)⌋,T = 3202 时得到 8。这是 Newey 与 West 建议过的一种滞后阶数,不是唯一选择。滞后改了,t 会改。
读这张表的方式:大约一半的 AAPL 日波动和 SPY 同向;β 的 t 值在 HAC 之后仍然很大。α 的普通 t 值刚过 2,HAC 之后降到 1.96 以下。无风险利率在 2014–2021 年远低于 4%,在 2023 年之后高于 4%,整段用一个 4% 会扭曲超额的水平。因此这个 α 只用来比较两种标准误,不能写成「苹果在样本里有显著超额」。换一只股票再做一次,就进入下一节的多重检验。
11. 一次检验和五十次检验
原假设 H₀ : α = 0。t 值是估计量除以它的标准误。双侧 p 值是「若原假设为真,出现这么极端的 t 的概率」。p = 0.03 的意思是:在 α 真的为 0、模型也设对了的前提下,这样的样本大约 3% 的机会出现。它不是「策略有 97% 的概率有效」。
大样本双侧 5% 的临界值是 1.96。t = 2.1 的正态双侧 p 值是 0.0357,单次检验会拒绝原假设。
若这 2.1 是 50 组参数里最好的一组,Bonferroni 把显著性水平除以尝试次数:
α_one = 0.05/50 = 0.001
标准正态双侧 0.001 的临界值是 3.291。2.1 低于 3.291,这组参数过不了整体 5% 的门槛。Harvey, Liu & Zhu (2016, RFS 29(1)) 在因子发表的语境里把经验门槛放到 t > 3 附近,理由是全行业已经试过很多次。个人研究日志要记下尝试次数,这是 docs/workflow.md 里的纪律。控制错误发现率(Benjamini–Hochberg–Yekutieli)比 Bonferroni 宽,M08 再比较这些修正。Deflated Sharpe Ratio(Bailey & López de Prado, 2014, JPM 40(5))把尝试次数、偏度和峰度同时放进夏普的概率。可核对的月频例子在 M08:年化夏普 1.20、T = 120、M = 100 时,相对 0 是 0.999555,紧缩之后是 0.659086。不要把这一个概率当成短样本的固定折扣。
12. Newey–West 在改哪一个数
连着拍的照片会把同一次颠簸数成很多张。波动聚集和自相关就是这样:今天的残差像昨天,日历上的 T 虚增了。 三明治公式先把这些连拍挤干,再重算标准误。斜率不动,动的是 t 值里的水分。 HAC 不是把系数往零缩的收缩估计。点估计仍是普通回归的那一个。 第 10 节里 β 的 t 从 58 降到 41,α 的 t 从 2.02 降到 1.96,就是挤掉水分之后的读法。
金融残差常常方差聚集,也常常自相关。普通 OLS 标准误假定残差独立、同方差。这两条不成立时,t 值会偏大。Newey & West (1987, Econometrica 55(3)) 用 Bartlett 核估计得分的长期方差:
ˆVar(ˆβ) = 1/T(X′X/T)⁻¹ ˆS (X′X/T)⁻¹
ˆS = ˆΓ₀ + Σⱼ₌₁ᴸ(1 − j / (L + 1))(ˆΓⱼ + ˆΓⱼ′), ˆΓⱼ = 1/T Σₜ₌ⱼ₊₁ᵀ xₜ eₜ eₜ₋ⱼ xₜ₋ⱼ′
点估计 ˆα, ˆβ 不变,变的是标准误。第 10 节里 β 的 t 从 58 降到 41,结论仍是「斜率明显不为 0」。α 的 t 从 2.02 降到 1.96,结论从「刚过线」变成「不过线」。HAC 不是把系数缩小的收缩估计。
statsmodels 在本仓库的 ml 可选依赖里,默认环境不一定装了。教学脚本用 NumPy 实现了上面的三明治,避免为了一个 t 值去改环境。若已安装,对照写法是 OLS.fit(cov_type="HAC", cov_kwds={"maxlags": L})。两边的小样本自由度修正可能差在第三位,比较时要看文档里除的是 T 还是 T − k。
13. 平稳与协整:先写对原假设
单位根像广场上乱走的醉汉:下一步从现在的位置出发,价格水平自己不回到原点。
平稳像拴在木桩上的弹簧:拉开以后,期望会往桩的方向缩。
协整是醉汉用狗绳牵着狗。人和狗各自都在乱走,两者的距离被绳子约束,这个距离可以是平稳的。
绳子的比例若是你看着两条价格凑出来的,残差检验要比普通 ADF 更严,临界值用 MacKinnon 的协整表。
自己跑一次 adfuller,p 值对不上那张表。
ADF 的原假设是「有单位根」。p 值小,才是拒绝单位根、支持平稳的证据。p 值大,只是没有拒绝,不是证明随机游走。股价的水平通常不拒绝单位根,收益通常会拒绝。检验的是你放进去的那一列,把价格和收益弄反,结论会整个翻过来。
协整(Engle & Granger, 1987, Econometrica 55(2)):两个本身不平稳的序列,存在一个系数使残差平稳。Engle–Granger 两步法的原假设是「不存在协整」。残差上的临界值不是普通 ADF 表,要用 MacKinnon 的协整临界值。statsmodels.tsa.stattools.coint 做的是这件事。对两只高相关股票的价差直接跑 adfuller,p 值没有表格上的含义。
相关 0.95 只说明两条价格常常同向。同向可以来自共同的市场因子,价差仍然可以漂走。配对交易要先看到残差平稳,再谈均值回归的持有期。样本里的协整到了样本外会消失,M02 把这当成策略风险,而不是统计附录。
🔴 深入层:边界与争论
14. 夏普自己的标准误
Lo (2002) 在独立正态的假设下给出,与收益同一频率的夏普估计量满足:
SE(ˆSR) ≈ √((1 + SR²/2) / T)
T 是计算这个夏普时用的期数。年收益算出来的年化夏普,T 才是年数。日收益年化后再把年数代进这条公式,把两套频率混在了一起。
手算。 用五年的年收益估计,真实夏普按 1 计:
SE = √((1 + 0.5) / 5) = √0.3 = 0.5477
正态近似的 95% 区间大约是 1 ± 1.96 × 0.5477,即 [−0.074, 2.074]。五年夏普等于 1,区间仍然跨过 0。这就是「夏普 1 听起来很好,统计上可能什么都没说」。
在原假设 SR = 0 下,Lo 的标准误退回 √(1/T),ˆSR / SE 回到第 8 节的 t = SR √T。多出来的 SR²/2 影响的是「已知夏普不为零时,估计有多准」,不是零假设的检验临界值。日频年化时,SR_daily 很小,SR²/2 几乎可以忽略,年化夏普的标准误接近 1/√Y。把年化夏普 1 和 T = 5 直接代进 Lo 公式,会把标准误从大约 0.45 抬到 0.55,属于频率用错,不是更保守的美德。
自相关会再改这个标准误。种子数据 ρ₁ = −0.114,独立假设不成立。本章报告方向,不另造一个「调整后夏普」。
15. 非正态、收缩与自助法
t 临界值 1.96 来自正态或大样本。Pearson 峰度 17 的日收益上,用正态去算「五年内不可能出现的跌幅」,第 10 节已经给出反例:≤ −5% 的天数,正态预期 0.004,实际 6。VaR 若只用 μ − 2.33σ,会沿用这个错误。M04 改用历史分位或预期亏损。
协方差矩阵在资产数接近样本数时会病态。Ledoit & Wolf (2004, Journal of Multivariate Analysis 88(2)) 把样本协方差向一个结构化目标收缩。那是 M11 的输入,本章只记住:样本相关矩阵的特征值不要直接拿去优化。
独立同分布自助法会打乱时间顺序,把波动聚集抽没。时间序列要用块自助法(Künsch, 1989, The Annals of Statistics 17(4)),块长本身是一个选择。块长没写进实验记录,区间就不能和别人比。
16. 标准误之争对个人研究的含义
经济学界对 HAC 的滞后、对聚类标准误的层级有持续争论。落到个人港美股研究,实用的次序是:
- 先去掉前视和复权错误。这类错误比 HAC 大一个数量级。
- 日频或月频因子回归报告 HAC,滞后规则写进笔记。
- 尝试次数写进日志,再谈 t 是 2 还是 3。
- α 的点估计要配无风险利率的口径。整段样本用一个常数利率,只能做标准误的演示。
17. 手写 NumPy 与 scipy / statsmodels 对照
第 9 节到第 13 节的数字都由 NumPy 算出来。scipy 和 statsmodels 在默认环境里不一定装了。下表左边是本节要核对的打印,右边是装上之后的标准调用。没装时,脚本打印 skipped,不改左边的数。
| 任务 | 纯 NumPy 六位打印 | 标准调用 |
|---|---|---|
| Jarque–Bera | 0.507256 | scipy.stats.jarque_bera |
| 四点 OLS 的 t | 0.936329,6.159290 | OLS.fit() 的默认协方差 |
| 同一四点,HAC,L = 1 | 1.352122,14.034377 | OLS.fit(cov_type="HAC", cov_kwds={"maxlags": 1}) |
| ADF 回归的系数和 t | -2.300000,-23.000000 | adfuller(..., maxlag=0, regression="c", autolag=None) |
| Engle–Granger 斜率与残差 t | 2.017143,-3.143195 | coint(..., trend="c", autolag=None) |
Jarque–Bera 用第 9 节那五个收益 −0.04, −0.01, 0, 0.01, 0.02。矩偏度打印 −0.692728,Pearson 峰度 2.282129,和正文里收成三位的 −0.693、2.28 是同一组矩。n = 5 时
JB = n/6(S² + ((K − 3)²) / 4) = 0.507256
正态参照仍是 Pearson 峰度 3。这个统计量很小,五个点说明不了肥尾。
四个点的斜率仍是 1.20286,截距仍是 0.002743。普通 t 是 0.936329 和 6.159290。L = 1 的 Bartlett 三明治把 t 变成 1.352122 和 14.034377。点估计没有变。这个小样本里 HAC 把 t 抬高了,和第 10 节把 α 的 t 从 2.021 降到 1.956 方向相反。三明治改的是标准误,残差怎样相关,t 就朝哪边动。statsmodels 若再做小样本修正,第三位可能不同,比较时要看协方差除的是 T 还是 T − k。
ADF 的教学序列是 1.0, 1.1, 0.9, 1.2, 0.8, 1.3。回归是 Δ yₜ = a + ρ yₜ₋₁ + eₜ,没有再加滞后差分。ˆρ = −2.300000,t = -23.000000。自由度只有 3。-23 不是「已经证明平稳」,临界值也不是 1.96。adfuller 还会给出 MacKinnon 的 p 值,那一列才是单位根检验的读法。
协整的两列是 x = (1, 2, 3, 4, 5, 6),y = (2.0, 3.9, 6.1, 8.0, 9.8, 12.2)。第一步斜率 2.017143。残差再做上面那种 ADF 回归,t = -3.143195。Engle–Granger 的原假设是没有协整,临界值用 MacKinnon 的协整表,比普通 t 更严。-3.143195 只说明残差回归的算术,不能在这里拒绝「没有协整」。coint 做的是带那张表的检验。
可选库没装上时,对照行降级成这四句,手算的六位不变:scipy_jb skipped,statsmodels_hac skipped,statsmodels_adf skipped,statsmodels_coint skipped。
def library_reference() -> None:
    """手写结果始终打印。库未安装时只打印 skipped,不改前面的六位。"""
    toy = np.array([-0.04, -0.01, 0.00, 0.01, 0.02])
    stat, skew, kurt = jarque_bera(toy)
    print("jb", f"{stat:.6f}", "skew", f"{skew:.6f}", "kurt", f"{kurt:.6f}")
    try:
        from scipy import stats

        scipy_stat, _p = stats.jarque_bera(toy)
        print("scipy_jb", f"{float(scipy_stat):.6f}")
    except ImportError:
        print("scipy_jb", "skipped")
    try:
        import statsmodels.api as sm
        from statsmodels.tsa.stattools import adfuller, coint

        fit = sm.OLS(y, sm.add_constant(x)).fit(
            cov_type="HAC", cov_kwds={"maxlags": 1},
        )
        print("statsmodels_hac_t", f"{float(fit.tvalues[0]):.6f}")
        adf_out = adfuller(level, maxlag=0, regression="c", autolag=None)
        coint_out = coint(left, right, trend="c", autolag=None)
        print("statsmodels_adf_t", f"{float(adf_out[0]):.6f}")
        print("statsmodels_coint_t", f"{float(coint_out[0]):.6f}")
    except ImportError:
        print("statsmodels_hac", "skipped")
        print("statsmodels_adf", "skipped")
        print("statsmodels_coint", "skipped")
Deflated Sharpe 的一组月频手算不在这里重复。M08 第 10 节给出年化夏普 1.20、T = 120、M = 100 时,相对 0 的概率 0.999555,放进选择门槛之后是 0.659086。那一节的分位数同样用二分法,不依赖 scipy.stats.norm。
真实案例
案例 1:1987-10-19,正态刻度外面的一天
Fortune(1993, Federal Reserve Bank of Boston, New England Economic Review)的表记录,标普 500 当日收盘相对前收 −20.47%,道琼斯工业指数约 −22.6%。文中同时描述了开盘不平衡、指数期货贴水和程序交易、组合保险之间的反馈。若拿日波动 1% 的正态钟形当尺子,−20.47% 大约在 20 个标准差之外;事前波动即使更高,这一天仍然不是「三年一遇的 2 倍标准差」。个人账户的含义:用「波动率 × 2」做唯一止损,会在这种日子里失去参照。M04 的回撤预算要按历史最差日和保证金规则一起写,而不是按正态分位。
案例 2:2020-03-16,同一套种子数据里的标准差
实验室 SPY 复权序列在 2020-03-16 的日收益是 −10.94%,相对 2019 年日波动 0.788% 为 −13.9 个标准差。2019 年年化波动只有 12.51%,按正态几乎不可能。实际样本里 ≤ −5% 的日子有 6 天,正态参照是 0.004 天。风控若在 2 月底还用 2019 年的波动设阈值,3 月中旬会连续触发,并且触发本身改变仓位,后面的样本不再是原来的分布。这是 M04 和 M11 要接过去的状态依赖,不是把峰度再报高一位。
案例 3:2022 年,相关从负号变成正号
Vanguard 的测算里,60% 标普 500 加 40% Bloomberg 美国综合债券指数的组合在 2022 年收益为 −16.1%(全球分散的 60/40 口径是 −15.7%)。同一年若把债券换成美国国债,别的机构会得到不同的百分比,例如 Morgan Stanley 用标普全收益和国债的口径写过 −17.5%。引用时必须带上指数对。机制是通胀和加息同时压低股票估值和债券价格,过去二十年里负的股债相关在这一年失效。用 2000–2021 年的相关矩阵去算 2022 年的组合波动,会低估实际亏损。M11 的滚动窗和压力窗就是针对这种换挡。
方法论来源
| 概念 | 出处 |
|---|---|
| 夏普比率 | Sharpe (1966), Journal of Business 39(1);Sharpe (1994), JPM 21(1) |
| 年化与自相关 | Lo (2002), Financial Analysts Journal 58(4) |
| ARCH / GARCH | Engle (1982), Econometrica 50(4);Bollerslev (1986), Journal of Econometrics 31(3) |
| 协整与临界值 | Engle & Granger (1987), Econometrica 55(2);残差检验用 MacKinnon 临界值 |
| Newey–West | Newey & West (1987), Econometrica 55(3) |
| 多重检验 | Harvey, Liu & Zhu (2016), RFS 29(1) |
| Deflated Sharpe | Bailey & López de Prado (2014), JPM 40(5) |
| 协方差收缩 | Ledoit & Wolf (2004), Journal of Multivariate Analysis 88(2) |
| 块自助法 | Künsch (1989), The Annals of Statistics 17(4) |
| Jarque–Bera | Jarque & Bera (1987), International Statistical Review 55(2)。五日例子的统计量是 0.507256 |
| ADF | Dickey & Fuller (1979), JASA 74(366)。本节的 −23 是回归 t,不是 MacKinnon p 值 |
| 1987-10-19 收盘跌幅 | Fortune (1993), Boston Fed New England Economic Review,表中 −20.47% |
| 2022 年 60/40 | Vanguard 测算:标普 500 + Bloomberg 美国综合债,−16.1% |
| 本章图的样本 | knowledge/Labs/momentum_plus_lab/seed_data/,2014-01-03 至 2026-09-28 |
💡 思考回顾与巩固
核心认知纠偏
| 常见误区 | 反例 | 用法 |
|---|---|---|
| p = 0.03 表示策略有 97% 的概率为真 | p 值的条件是「原假设为真」 | 换一种说法:在 α=0 的世界里,这样的样本有多稀少 |
| t > 2 就可以保留参数 | 50 次尝试后,双侧 5% 的 Bonferroni 临界值是 3.29;t = 2.1 的 p 值是 0.0357 | 日志里的尝试次数先写下来 |
| pandas 的峰度,正态应该等于 3 | Series.kurt 默认是超额峰度,正态参照是 0。本章矩估计的 Pearson 峰度,正态才是 3 |
写峰度时写上估计量的名字 |
| 四点回归 R² = 0.95 说明关系很强 | 自由度只有 2,临界 t 约 4.30。四个点的共线不构成外推 | 同时报告 n 和自由度 |
| 相关 0.95 就可以配对 | 相关不检验价差是否平稳。协整检验的原假设是「没有协整」,临界值也不是普通 ADF | 用 coint 或 MacKinnon 临界值 |
| 年化夏普 1、样本 5 年,直接代入 Lo 公式 | 那条公式的 T 必须和夏普同一频率。日频年化夏普对应的年数标准误约 1/√5,不是 √(1.5/5) | 先写明收益的频率 |
| 种子数据里 AAPL 的 α t 值刚过 2,所以有超额 | HAC 后 t = 1.956,而且整段无风险利率被设成常数 4% | 这张表只比较标准误 |
费曼自测
- 为什么组合用简单收益加权,多期累加却用对数收益?
- t = SR √Y 的 SR 必须是哪一种夏普,年数 Y 怎么从日频样本数得到?
- Newey–West 改变了 α 的估计值吗?它在第 10 节的例子里改变了什么结论?
- 正态参照说 ≤ −5% 的日子几乎不会出现,种子数据里出现了几次?这如何影响「2 倍标准差止损」?
自测要点
1. 组合在一天之内的盈亏是各资产简单收益乘以前一日权重。对数收益的加权和不会等于组合对数收益,除非权重退化或者收益无穷小。跨很多天把财富连起来时,对数收益相加等于价格比的对数,所以模型里常拿它做可加的噪声。记账仍用简单收益连乘。 2. 必须是先减日无风险利率、再除以样本标准差、再乘 √252 的那个夏普,也就是 `metrics.py` 的定义。Y = n/252,其中 n 是日收益个数。若夏普已经用月收益和 √12 年化,根号里就要用月数除以 12,不能再除一次 252。 3. 点估计不变。改变的是标准误和 t。第 10 节里 α 的 t 从 2.021 降到 1.956,双侧 5% 的结论从拒绝变成不拒绝。β 的 t 从 58 降到 41,结论不变。 4. 3202 天里有 6 天 ≤ −5%,正态参照约 0.004 天。2 倍标准差若按全样本日波动 1.08% 计算,大约是 −2.2% 的日子,阈值里面会挤进很多普通波动;若按 2019 年的低波动计算,2020-03-16 这种 −10.94% 会远远冲破,并且连续触发会改变后面的仓位。止损阈值要单独做历史压力,而不是正态换算。四维习题
A. 概念题
- 为什么组合日收益用简单收益加权,研究多期连加时却用对数收益?各举一个数值说明两者不能互换。
- p = 0.03 能否说成「策略有 97% 的概率有效」?写出这个概率的条件。
- 两只股票价格相关 0.95,是否足以做配对交易?应检验的原假设是什么,临界值为什么不是普通 ADF?
- Pearson 峰度、超额峰度和
pandas.Series.kurt各以什么数表示正态?
B. 计算题
- 两天收益 +10%、−10%。给出简单收益累计、对数收益累计,以及对数收益指数化之后的简单收益。+50% 的对数收益是多少?
- 年化夏普 0.8(定义同第 8 节)。t 达到 2 和达到 3 各需要多少年?三年夏普 1.5 与二十年夏普 0.6,哪一个 t 更大?
- 50 次尝试里最好的 t 是 2.1,整体显著性水平 5%。Bonferroni 的单次 p 值门槛是多少?对应的正态临界 t 是多少?这组参数是否通过?
- 用第 9 节的四个点,手算 ¯x, ¯y, ˆβ, ˆα。
- 年收益频率上的夏普为 1、T = 5。Lo 的标准误是多少?95% 区间大约是什么?若有人把日频年化夏普代进同一公式,错在哪里?
C. 编程实战题
- 读取
knowledge/Labs/momentum_plus_lab/seed_data/spy.csv的adj_close,计算 2014-01-03 至文件末日的日收益矩偏度、Pearson 峰度、≤ −5% 的天数,以及同均值同方差正态参照下的期望天数。不要把结果写回教材;把窗口和估计量名字写进自己的笔记。 - 用同一目录能对上的 AAPL 复权价,对 SPY 做日超额回归,无风险利率先固定为年化 4% 并在输出里打印。同时打印 OLS t 值和滞后阶 L = ⌊4(T/100)^(2/9)⌋ 的 Newey–West t 值。
- 把第 11 题的无风险利率改成 0 和 0.02,观察 β 是否变化、α 是否变化,并用一句话解释。
D. 个人实战思考题
- 你的实验日志准备用哪三个字段记录一次尝试,才能在事后做 Bonferroni?
- 港股日频策略若误用 √252,波动会被高估还是低估?你的数据里一年实际有多少个交易日,准备用哪个数?
- 2022 年股债同跌之后,你还会把「股债相关为负」写进组合的长期假设吗?要保留的话,哪一种压力情景必须另算?
完整参考答案与解析
**A1.** 组合在 t 日的简单收益等于 `Σᵢ w_(i,t−1) R_(i,t)`。若把对数收益按同样权重相加,得到的不是 ln(1 + Σ w R)。数值:两资产等权,收益 +50% 与 −50%,组合简单收益是 0;对数收益 ln 1.5 + ln 0.5 = ln 0.75,等权平均约 −0.144,再指数化约 −13.4%,和组合的 0 不是一回事。多期则相反:价格 100 → 110 → 99,对数收益 ln 1.1 + ln 0.9 = ln 0.99 直接给出全段;简单收益必须 1.1 × 0.9 − 1 = −1%。 **A2.** 不能。0.03 是在「α 真为 0、回归设定正确、标准误口径也正确」的条件下,观察到当前或更极端样本的概率。策略为真的概率还取决于检验之前你有多相信它,以及你试了多少次。那是贝叶斯问题,p 值没有做这一步。 **A3.** 不足以。高相关只衡量同向波动。配对要问价差或回归残差是否平稳。Engle–Granger 的原假设是不存在协整。残差是估计出来的,单位根检验的临界值比普通 ADF 更严,要用 MacKinnon 协整临界值。相关 0.95 的两只股票可以因为同一个市场因子同涨同跌,价差仍有单位根。 **A4.** Pearson 峰度 m₄/m₂² 在正态下为 3。超额峰度是它减 3,正态下为 0。`pandas.Series.kurt` 默认是调整后的超额峰度,正态参照也是 0,而且和「除以 n」的矩估计在小样本上不同。本章五日例子的 Pearson 峰度是 2.28,不能和 pandas 的输出直接比,除非关掉调整并改成 Pearson。 **B5.** 简单累计 1.1 × 0.9 − 1 = −0.01。对数累计 ln 0.99 = −0.0100503。exp(−0.0100503) − 1 = −0.01。ln 1.5 = 0.405465。 **B6.** Y = (2/0.8)² = 6.25 年达到 t = 2;(3/0.8)² = 14.0625 年达到 t = 3。1.5 √3 = 2.598,0.6 √20 = 2.683。二十年、夏普 0.6 的 t 略大。这个比较假定夏普的定义就是第 8 节那一个,而且日收益独立。 **B7.** 门槛 0.05/50 = 0.001。标准正态双侧临界值 Φ⁻¹(0.9995) = 3.291。t = 2.1 的双侧 p 值是 0.0357,大于 0.001,不能通过。它仍小于 0.05,所以「单次看起来显著、五十次里的最优不显著」可以同时成立。 **B8.** ¯x = (0.01 − 0.02 + 0.02 + 0) / 4 = 0.0025。¯y = (0.015 − 0.018 + 0.030 − 0.004) / 4 = 0.00575。离差交叉乘积之和 0.0010525,离差平方和 0.000875,ˆβ = 1.20286,ˆα = 0.00575 − 1.20286 × 0.0025 = 0.002743。 **B9.** √((1 + 0.5) / 5) = √0.3 = 0.5477。区间约 1 ± 1.96 × 0.5477 = [−0.074, 2.074]。日频年化夏普已经乘过 √252,对应的「年」标准误在原假设附近约 1/√Y。把年化夏普 1 和 T = 5 直接代入,等于假装这 5 个观测是五年的年收益,并且把 SR²/2 按年化夏普的量级放了进去。 **C10–C12.** 参考实现读取种子文件。窗口以文件内的日期为准。import math
from pathlib import Path
import numpy as np
import pandas as pd
SEED = Path("knowledge/Labs/momentum_plus_lab/seed_data")
def load_adj(name: str) -> pd.Series:
path = SEED / "spy.csv" if name == "SPY" else SEED / "_cache" / f"{name}.csv"
frame = pd.read_csv(path, parse_dates=["session"])
return frame.set_index("session")["adj_close"].astype(float).sort_index()
def norm_cdf(x: float) -> float:
return 0.5 * (1.0 + math.erf(x / math.sqrt(2.0)))
def ols_t(y: np.ndarray, x: np.ndarray) -> tuple[float, float, float, float]:
design = np.column_stack([np.ones(len(x)), x])
coef, *_ = np.linalg.lstsq(design, y, rcond=None)
resid = y - design @ coef
dof = len(y) - 2
sigma2 = float(resid @ resid) / dof
xtx_inv = np.linalg.inv(design.T @ design)
se = np.sqrt(np.diag(xtx_inv) * sigma2)
t_stat = coef / se
return float(coef[0]), float(coef[1]), float(t_stat[0]), float(t_stat[1])
def nw_t(y: np.ndarray, x: np.ndarray, lags: int) -> tuple[float, float]:
# Bartlett 核。点估计与 OLS 相同,这里只返回 t。
design = np.column_stack([np.ones(len(x)), x])
coef, *_ = np.linalg.lstsq(design, y, rcond=None)
resid = y - design @ coef
scores = design * resid[:, None]
n_obs = len(y)
meat = scores.T @ scores
for lag in range(1, lags + 1):
weight = 1.0 - lag / (lags + 1.0)
gamma = scores[lag:].T @ scores[:-lag]
meat = meat + weight * (gamma + gamma.T)
meat = meat / n_obs
bread = np.linalg.inv(design.T @ design / n_obs)
se = np.sqrt(np.diag(bread @ meat @ bread / n_obs))
t_stat = coef / se
return float(t_stat[0]), float(t_stat[1])
spy = load_adj("SPY")
r = spy.pct_change().dropna()
center = r - r.mean()
m2 = float(np.mean(center**2))
skew = float(np.mean(center**3) / m2**1.5)
kurt = float(np.mean(center**4) / m2**2)
std = float(r.std(ddof=1))
z_cut = (-0.05 - float(r.mean())) / std
print(r.index.min().date(), r.index.max().date(), len(r))
print("skew", round(skew, 3), "pearson_kurt", round(kurt, 2))
print("days_le_-5pct", int((r <= -0.05).sum()), "normal", round(len(r) * norm_cdf(z_cut), 4))
aapl = load_adj("AAPL")
both = pd.concat([spy.rename("SPY"), aapl.rename("AAPL")], axis=1, join="inner")
ret = both.pct_change().dropna()
for rf in (0.04, 0.0, 0.02):
daily = rf / 252.0
y = (ret["AAPL"] - daily).to_numpy()
x = (ret["SPY"] - daily).to_numpy()
alpha, beta, t_a, t_b = ols_t(y, x)
lags = int(math.floor(4.0 * (len(y) / 100.0) ** (2.0 / 9.0)))
nw_a, nw_b = nw_t(y, x, lags)
print(
"rf", rf, "beta", round(beta, 3), "alpha_bps", round(alpha * 1e4, 2),
"t_ols", round(t_a, 3), round(t_b, 2),
"t_nw", round(nw_a, 3), round(nw_b, 2), "L", lags,
)
📌 章节知识总结
一句话核心洞察
- 组合用简单收益加权,多期对数收益只用于可加的统计模型;净值仍由简单收益连乘。
- t = SR √Y 里的夏普要和
metrics.py一致,Y = n/252。这是均值的 t,不是 Lo 的夏普区间。 - 正态峰度是 3 还是 0,取决于你报的是 Pearson 还是超额。种子数据的 Pearson 峰度是 17.39。
- 五十次尝试之后,t = 2.1 过不了 Bonferroni 的 3.29。尝试次数写在看到结果之前。
- Newey–West 不改变 ˆα 和 ˆβ。AAPL 对 SPY 的 α t 值从 2.021 降到 1.956,结论因此改变。
公式与参数速查
| 名称 | 表达式 | 前提 |
|---|---|---|
| 简单 / 对数 | R = Pₜ/Pₜ₋₁ − 1,r = ln(1 + R) | 价格已复权 |
| 独立年化波动 | s √252 或 s √12 | 与数据频率匹配;日收益弱相关 |
| 一阶修正 | s √N √(1 + 2ρ₁) | 只适合作为方向;高阶相关未纳入时不要当正式波动 |
| 夏普 | (¯R − r_f/252) / s · √252 |
同 metrics.py |
| t 与夏普 | t = SR √Y,Y = n/252 | 独立同分布的经典标准误 |
| 矩偏度 / Pearson 峰度 | m₃ / m₂^(3/2),m₄/m₂² | 除以 n;正态峰度为 3 |
| OLS 斜率 | 中心化后的协方差比 | 残差方差分母 n − k |
| Bonferroni | 0.05/m;m = 50 时临界约 3.29 | 大样本正态,控制族错误率 |
| Newey–West 滞后 | L = ⌊4(T/100)^(2/9)⌋ | 规则之一;本章样本 T = 3202 时 L = 8 |
| Lo 标准误 | √((1 + SR²/2) / T) | T 与 SR 同一频率 |
| ADF 原假设 | 有单位根 | p 小才支持平稳 |
| 协整原假设 | 没有协整 | 临界值用 MacKinnon,不是普通 ADF |
| 五日 Jarque–Bera | 0.507256 | 偏度 −0.692728,Pearson 峰度 2.282129 |
| 四点 HAC,L = 1 | t 为 1.352122 与 14.034377 | 点估计仍是 0.002743 与 1.20286 |
| 本章 SPY ≤ −5% | 6 天 / 正态参照 0.004 天 | 2014-01-03 至 2026-09-28 的种子复权价 |
跨模块联结
| 本章结论 | 下游 | 工程落点 |
|---|---|---|
| 夏普与年化定义 | M00 已用,M03 的绩效表继续用 | src/quant/backtest/metrics.py |
| t 与尝试次数 | M08 的因子门槛 | docs/workflow.md |
| HAC 与时序回归 | M06 | 研究脚本要声明滞后阶 |
| 协整不是相关 | M02 配对 | 检验用协整临界值 |
| 肥尾与相关换挡 | M04、M11 | 回撤和压力相关,不只是 σ |
| 图的数据 | 动量 Plus 实验室 | knowledge/Labs/momentum_plus_lab/seed_data/ |
学习指引
- 对照原书:GK 附录 C 笔记 看收益和回归在主动管理书里的角色;因子第 2 章笔记 看 Newey–West 将在 M06 哪里被当成默认标准误。
- 回查时机:M03 对绩效表,M02 对协整,M06 对回归和 HAC,M08 对 t > 3,M11 对收缩协方差。
- 下一步:若要做策略,先读 M02。统计定义不够用时再回到本章,不必按页读完。
自检清单
- 能手算两天 +10%、−10% 的简单收益和对数收益
- 能说出 t = SR √Y 和 Lo 标准误各用在什么频率
- 能解释 Bonferroni 下 t = 2.1、m = 50 为什么不显著
- 能指出 pandas 超额峰度和 Pearson 峰度的正态参照
- 跑过第 10 节的脚本或习题代码,窗口与教材一致
- 能复述 Jarque–Bera 0.507256、ADF 回归 t -23.000000,以及未安装时的
scipy_jb skipped - 能说明 AAPL 回归里 HAC 改变的是 t 值,不是 β
- 引用 1987 或 2022 时能说出来源和口径