M11 风险模型
层级:L3 组合管理 | 优先级:★★ | 预计学时:12 小时 对应原书:GK 第 3 章;因子 7.2;黑箱第 4 章 前置知识:M01 的波动与相关;M10 的残差波动。 读书笔记:GK 第 3 章的风险拆分 状态:reviewed 数据截至:2026-09|最近复核:2026-10-28
学习目标
- 用一个两债券的例子说明 95% VaR 可以违反次可加性,以及波动率为什么仍被用来拆风险。
- 手算 Σ = XFX′ + Δ 的组合方差,把因子部分和特质部分分开。
- 手算两只股票的风险贡献,看出等权不等于风险各半。
- 区分一个月的协方差、长程方差,以及本仓库实际使用的样本协方差。
- 用 French 月频看相关会变号,但不把 12 个月的相关写成新的协方差。
- 在决策日之前的窗口上向量化计算常数相关收缩,并指出
LedoitWolf的默认目标是另一张矩阵。
本章知识拓扑图
flowchart TB
    X["已知的暴露 X"] --> SIGMA["Σ = X F X' + Δ"]
    F["因子协方差 F"] --> SIGMA
    D["特质方差 Δ"] --> SIGMA
    SIGMA --> VOL["组合波动 √(w'Σw)"]
    VOL --> RC["风险贡献,加总等于波动"]
    RC --> M12["M12 在上限内分配权重"]
    HIST["窗口在决策日之前结束"] --> F
M10 给出每只股票的预期残差收益。本章给出这些头寸已经承担的波动从哪里来。生产环境的估计器在 src/quant/risk/volatility.py:用决策日之前的日收益做样本协方差,再乘 252。它不用指数加权,也不做收缩。
🟢 入门层:先看清已经下的注
1. 波动率能加总,VaR 不一定
次可加性要求:两笔风险合在一起,风险指标不能比分开报的总和更大。分散至少不该制造新的风险读数。 波动满足这一点,组合波动不超过两边按权重加总的上限。95% VaR 不必满足。 两只债券可以各自的 VaR 是 0,合在一起却有一笔会违约,组合 VaR 变成 100。0 加 0 小于 100。 所以风险预算用波动或期望短缺来加,不用 95% VaR 的数字相加。
波动率是收益的标准差。它对称,不单独描述左尾。它能拆,是因为组合方差是 w′ Σ w,每一块都能指回因子或个股。
95% VaR 是损失分布的 0.95 分位数。它不满足次可加性。手算:两只债券各自以 4% 的概率损失 100,否则损失 0,违约相互独立。
单只债券损失为 0 的概率是 0.96,已经高于 0.95,所以 95% VaR 是 0。两只都平安的概率是
0.96² = 0.9216
两只的损失分布在 0 处的累积概率只有 0.9216,到 100 才超过 0.95。两只合在一起的 95% VaR 是 100。各自 VaR 之和是 0。合在一起的风险度量大于分着看的和。Artzner、Delbaen、Eber 与 Heath (1999, Mathematical Finance 9(3)) 把次可加性列为一致性风险度量的条件,并讨论期望短缺。本章不另算一个带原子的期望短缺数值。
GK 第 3 章仍用波动率做核心度量,因为优化和归因要的是能拆开的二次型。波动率不是尾部本身。2008 年 9 月至 2009 年 3 月,French 的 Mkt-RF 七个月复利是 −36.55%。这是超额收益,不是加上国债之后的总财富。
2. 样本协方差在股票数多于月份时不可逆
N 只股票的协方差有 N(N + 1) / 2 个自由参数。500 只股票是
500 × 501/2 = 125250
若暴露矩阵 X 已经由行业哑变量和风格得分给定,要估计的是 K × K 的因子协方差和 N 个特质方差。K = 17(11 个行业加 6 个风格,这是教学计数,不是某版 Barra 的官方个数)时,
17 × 18/2 + 500 = 153 + 500 = 653
若 X 本身还要用回归估计,再加 500 × 17 = 8500 个暴露,一共 9153,仍然少于 125250。病态来自观测数盖不住非对角元。优化器会把很小的特征值放进权重的分母里。M12 处理的是这件事的后果。
4 行、6 列的标准正态面板,种子 7,样本协方差的秩是 3,最小特征值在数值上是 0。T = 4 时去均值之后秩至多是 3。这样的矩阵不能拿去求逆。
15 到 25 只港美股、只做多,你真正用得上的是这几只之间谁贡献了波动,不是 500 只股票那张 125250 个参数的样本协方差。 两只看起来互不相关的持仓,若在同一行业,坏的一天会一起跌。波动还能拆开报;95% VaR 可以各自是 0、合在一起却不是 0。 样本协方差在股票数接近月份数时会病态。优化器若拿极小特征值当零风险,仓位会爆。进阶层先把方差拆成因子和特质,再谈怎么收缩。 做空某一列来「对冲干净」是机构风险模型的默认动作。杠杆上限 1.0 的账户做不到那一列空头,报告里的中性权重不能当成下单表。
15 到 25 只之间,波动贡献可以相加,因为组合方差是 w′Σw。 95% VaR 不能这样加。教学例子里两只各自是 0,合在一起是 100。500 只股票的样本协方差有 125250 个自由参数,个人持仓用不上那张表。
🟡 进阶层:拆开方差,再谈估计
3. 结构化模型
Σ = XFX′ + Δ
| 符号 | 含义 | 维度 |
|---|---|---|
| X | 暴露。行业哑变量或已经标准化的风格得分 | N × K |
| F | 因子收益的协方差 | K × K |
| Δ | 特质方差,对角 | N × N |
| w | 组合权重 | N |
Δ 取对角,是假设因子已经把共同部分吸走。剩下的相关若还很大,模型缺了因子,不是特质「真的独立」。
手算三只股票。市场波动用 18% 这个整数,不是 French 的估计。暴露 (0.8, 1.0, 1.4),特质波动 25%, 20%, 30%,权重 (0.50, 0.30, 0.20)。
βₚ = 0.5 × 0.8 + 0.3 × 1.0 + 0.2 × 1.4 = 0.98
因子方差 0.18² = 0.0324。组合里来自市场的一块是
0.98² × 0.0324 = 0.031117
三只股票的特质贡献是权重平方乘特质方差:
0.50² × 0.25² = 0.015625 0.30² × 0.20² = 0.003600, 0.20² × 0.30² = 0.003600
两只的特质贡献相同,原因不同:一只权重大、特质波动小,另一只相反。合计
0.031117 + 0.015625 + 0.003600 + 0.003600 = 0.053942
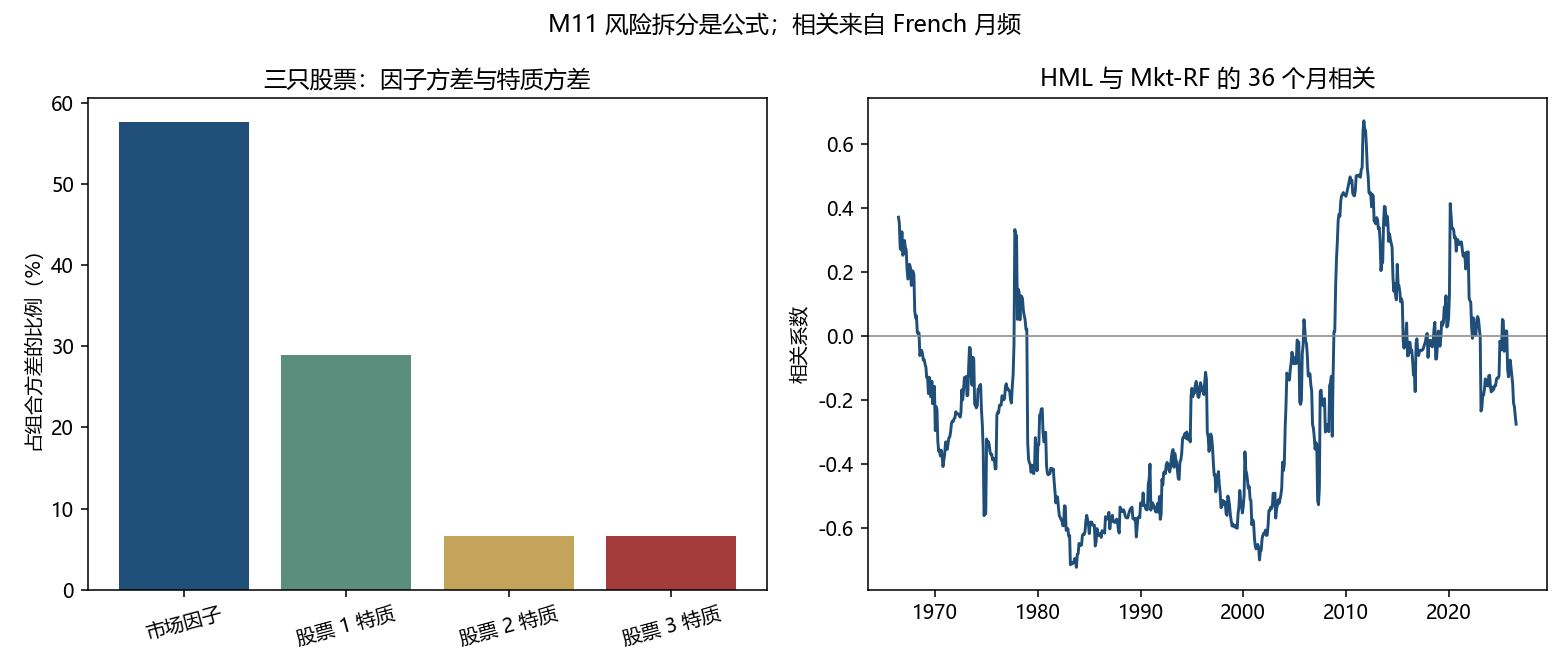
组合波动 √0.053942 = 23.23%。市场占方差的 57.69%,第一只股票的特质占 28.97%,后两只各占 6.67%。权重 20% 的高波动股票,不是这块方差里最大的特质项。
4. 风险贡献加总等于波动,不是等于 1
两只股票,波动 30% 和 20%,相关 0.5,各持一半。
σₚ² = 0.5² × 0.30² + 0.5² × 0.20² + 2 × 0.5 × 0.5 × 0.5 × 0.30 × 0.20
= 0.0225 + 0.0100 + 0.0150 = 0.0475, σₚ = 0.2179
边际项 (Σ w)₁ = 0.0600,(Σ w)₂ = 0.0350。风险贡献
RCᵢ = (wᵢ(Σ w)ᵢ) / σₚ
得到 0.1376 和 0.0803,加起来是 0.2179。占组合波动的份额是 63.16% 和 36.84%。资金各半,风险不是各半。份额也可以写成 wᵢ(Σ w)ᵢ / σₚ²,两个定义的比例相同,单位不同:前一个加总等于波动,后一个加总等于 1。
5. 纯因子组合只把其他因子的暴露清成 0
两只股票在行业 A,一只在行业 B,特质方差都是 1。暴露
X = [[1, 0], [1, 0], [0, 1]]
Δ = I 时,行业 A 的纯因子权重是 X(X′X)⁻¹ 的第一列,为 (0.5, 0.5, 0)。对 A 的暴露是 1,对 B 的暴露是 0。权重和是 1,不是美元中性。若再要求资金和为 0,那是另一个组合。截面回归的因子收益,在加权方式与这个组合一致时,才是它的收益。换一套行业权重,数值会变。
6. 横截面回归先处理国家、行业和风格叠在一起
Barra 一类模型在每个估计日做一次横截面回归:当天的收益对国家、行业和风格暴露回归,系数是这一天的因子收益,残差是特质收益。估计按四步走。
第一步,暴露只用当天已经知道的数据。国家是一列 1。行业是哑变量,一只股票通常只进一个行业。风格是当天估计宇宙里的标准化得分,均值和标准差都来自这一天,不来自全历史。第二步,承认国家列等于全部行业列之和,三组不能同时自由估计。做法是删掉国家,或者保留国家并加上约束:市值加权的行业因子收益之和为 0。不处理这个共线,(X′X)⁻¹ 不存在。第三步,第一遍用等权或市值权算出残差,再用特质方差的倒数做加权最小二乘。特质波动低的股票权重大。第四步,把每天的因子收益串成时间序列去估计 F,把残差的方差放进 Δ 的对角。只有一只股票的行业,残差被回归收成 0,这个 0 不是「没有特质风险」,不能拿去当特质方差。
手算只做第三步的对比。同一行业两只股票,当天收益 0.01 和 0.03,特质方差 0.04 和 0.01。等权因子收益是 (0.01 + 0.03) / 2 = 0.020000。加权权重正比于 1/0.04 = 25 和 1/0.01 = 100,和是 125。加权因子收益是
(25 × 0.01 + 100 × 0.03) / 125 = 0.026000
低特质波动的那只把因子收益从 0.020 拉到 0.026。上面三只股票的纯因子权重 (0.5, 0.5, 0) 对应的是特质方差都等于 1 的等权情形。特质方差一变,纯因子权重要重算,不能继续用 0.5。
import numpy as np


def cross_section_wls(returns: np.ndarray, specific_var: np.ndarray) -> float:
    """权重是特质方差的倒数。只有一只股票的行业残差为 0,不能当成特质方差。"""
    weights = 1.0 / specific_var
    return float(weights @ returns / weights.sum())


def shrink_eigenvalues(values: np.ndarray, strength: float = 0.5) -> np.ndarray:
    # 收到这组特征值的均值。不是 USE4 的偏差函数,也不是种子 7 的矩阵。
    target = float(np.mean(values))
    return (1.0 - strength) * values + strength * target
7. 特征值调整拦住的是被低估的小特征值
样本一短,碰巧同涨同跌的方向会被估成一条很窄的缝,最小特征值偏小。 优化器按 1/λ 配权重,会把这条缝当成几乎零风险的套利死角,仓位被极小的分母放大。 条件数是最大特征值除以最小特征值。它越大,求逆越不稳。 特征值调整把小的往上收、大的往下收,是为了让预测风险靠近事后实现的风险,不是 USE4 那套偏差函数本身。
因子收益的样本协方差 F 有一个熟悉的偏差:样本太短时,最大的特征值偏大,最小的特征值偏小。优化器按 1/λ 配置,会去持有那个被低估的方向,把它当成便宜的分散。特征值调整把小特征值往上收、把大特征值往下收,使预测的风险接近事后实现的风险。Menchero、Orr 与 Wang 的 USE4 笔记写的是一套模拟出来的偏差函数。本章不重估那套函数。
教学上把两个特征值收到它们的均值,强度 0.5。原特征值 0.0400 和 0.0100,均值 0.0250。调整后是
0.5 × 0.0400 + 0.5 × 0.0250 = 0.0325 0.5 × 0.0100 + 0.5 × 0.0250 = 0.0175
条件数从 0.0400/0.0100 = 4 降到 0.0325/0.0175 = 1.8571。小特征值上升,优化器不再因为一个过小的 λ 去重仓那个方向。这组和种子 7 那块面板的最小特征值 0.233 不是同一个矩阵。0.5 仍然是写下的强度,不是 USE4 估出来的最优值。
8. 波动率状态调整改的是整体水平,不是相关形状
F 若用过去很多个月估计,相关形状比较稳,水平会落后于最近的波动。波动率状态调整用一个标量去乘整个 F:最近实现的波动相对模型预测偏高,就把因子方差整体放大,相关矩阵先不动。特质方差可以另乘一个标量。本章这一次只放大因子那一块。
沿用第 3 节的市场波动 18%。若最近的实现波动是 27%,标量是 (0.27/0.18)² = 2.25。因子贡献 0.031117 × 2.25 = 0.070013。特质三项仍是 0.015625、0.003600、0.003600,合计 0.022825。新的组合方差是 0.092838,波动是 30.47%。因子占方差的份额从 57.69% 升到 75.41%。27% 是教学输入,不是 2020 年 3 月的测量。第 10 节里,下跌前的预测停在 9.78% 和 11.23%,而价格跌了 33.70%。状态调整要有一个已经升高的实现波动才能把 18% 放大;在波动还没升高的那一天,它不会提前变成 30.47%。
9. 收缩、长程方差,和仓库里真正在跑的估计
向常数相关收缩时,先保留样本方差,非对角换成「平均相关系数 × 两条标准差」。种子 7 的那块正态面板,平均相关系数是 0.1239。指定强度 δ = 0.5:
(1 − δ) S + δ F_目标
收缩后最小特征值 0.233,条件数 9.32。δ = 0.5 是为了让矩阵可逆而写下的数,不是 Ledoit 与 Wolf 估计出来的最优强度。他们 2003 年发表在 Journal of Empirical Finance 10(5),2004 年的常数相关版本发表在 Journal of Portfolio Management 30(4),向单位矩阵收缩的版本发表在 Journal of Multivariate Analysis 88(2)。第 12 节把常数相关收缩写成宽表上的向量化公式,δ 仍取 0.5。sklearn.covariance.LedoitWolf 的默认目标是缩放后的单位阵,强度由它自己估计。可选库没装上时,那个调用降级并打印 skipped,两套矩阵也不该相等。
Newey 与 West (1987) 的 Bartlett 长程方差,改的是多期求和的方差,不改单月协方差。2012-01 至 2021-12 共 120 个月,滞后按 L = ⌊4(T/100)^(2/9)⌋ 取 4。Mkt-RF 的长程方差是单月方差的 0.59 倍,HML 是 1.49 倍。市场这段的自相关为负,把单月方差乘 12 会高估长期求和的方差;HML 相反。不能把 Newey–West 理解成「风险一律上调」。持有期只有一个月时,仍用单月协方差。
CovarianceModel 的窗口在 session 左侧截断,不含当天。年化乘 252,用样本协方差。注释写明不做指数加权。教学上的 RiskMetrics 日频 λ = 0.94 只出现在下面的对照里,不进入这个类。
import numpy as np
import pandas as pd


def variance_pieces(beta: np.ndarray, factor_var: float, specific: np.ndarray, weights: np.ndarray) -> float:
    """因子一块用组合暴露的平方。特质一块用权重平方,避免把个股波动直接相加。"""
    factor_piece = float(weights @ beta) ** 2 * factor_var
    return factor_piece + float(np.sum(weights**2 * specific))


def trailing_vol(returns: pd.Series, session: pd.Timestamp, window: int = 60) -> float:
    # 与 CovarianceModel 一样,窗口在 session 之前结束。当天收益还不能进入今天的预测。
    history = returns.loc[:session].iloc[:-1]
    return float(history.iloc[-window:].std(ddof=1) * np.sqrt(252.0))
10. 2020 年 2 月的预测没有包含 3 月的路径
种子里 SPY 的复权收盘,2020-02-19 到 2020-03-23 的比值减 1 是 −33.70%。这是该文件的复权价格路径,不是官方标普 500 价格指数。预测只用 2020-02-19 之前的日收益:过去 60 日的样本年化波动是 9.78%,λ = 0.94 的指数加权是 11.23%。其后 23 个交易日的样本波动年化是 76.63%。23 天的年化本身很噪。能确认的是两条预测都停在 10% 附近,而这段价格跌了 33.70%。指数加权并没有提前提示这段跌幅。
🔴 深入层:模型只约束写进 X 的暴露
11. 相关会变号,12 个月不够重估
右图是 HML 与 Mkt-RF 的 36 个月相关系数。最低 −0.7240,出现在截至 1983-10 的窗口;最高 0.6711,出现在截至 2011-10 的窗口。截至 2021-12 是 0.2618,截至 2022-12 是 0.0510。2022 这一年单独的相关是 −0.0752,只有 12 个月。
2012-01 至 2021-12 的年化波动:Mkt-RF 13.64%,HML 10.51%,相关 0.1446。2022 年两个数的月波动年化是 23.19% 和 19.14%,同样只有 12 个点。不能用这一年的相关替换前十年的协方差,再送进优化器。
Menchero、Orr 与 Wang 的 USE4 方法笔记(MSCI,2011)讨论行业、风格和特征值调整。本章不重估 USE4,也不把他们的因子个数写成个人账户的必选项。Rosenberg (1974, JFQA 9(2)) 是市场之外的协方差结构这条线的早期论文。
模型没有的列,就约束不住。流动性、融券挤兑、公告日跳空都不在 X 里。M00 案例 4 引用高盛主经纪商对 2025-06-01 至 07-22 系统化股票基金约 −4.2% 的报道,样本是经纪商客户,不是全市场普查。MSCI 的评论把驱动写成垃圾股反弹、动量抛售和轧空。那不是「把 HML 中性了就没有风险」。
12. 面板窗口上的常数相关收缩
宽表的行是交易日 session,列是股票代码。决策日当天的收益要等收盘才知道,窗口用 loc[:session].iloc[:-1],和 CovarianceModel 一样把当天丢掉。下面四行里,最后一行三只股票都是 0.50,只用来核对它没有进协方差。
前三行去均值之后是
A : −0.01, 0, 0.01 B : 0.01, 0, −0.01 C : 0.03, 0, −0.03
样本协方差除以 T − 1 = 2。对角是 0.0001、0.0001、0.0009,非对角是 −0.0001、−0.0003、0.0003。相关是 −1、−1、+1,平均相关
¯ρ = (−1 − 1 + 1) / 3 = −⅓
样本矩阵的最小特征值在 10⁻¹⁹ 量级,四舍五入到 0,秩是 1。常数相关目标保留这三条样本方差,非对角换成 ¯ρ σᵢσⱼ。δ = 0.5 时
Σ_AB = 0.5 × (−0.0001) + 0.5 × (−⅓ × 0.0001) = −0.0000666667
Σ_AC = 0.5 × (−0.0003) + 0.5 × (−0.0001) = −0.0002000000
Σ_BC = 0.5 × 0.0003 + 0.5 × (−0.0001) = 0.0001000000
收缩后最小特征值是 0.0000243938,矩阵变成正定。年化是在这张矩阵上再乘 252。对固定的 δ,先收缩再乘 252,和先乘 252 再收缩,得到同一张年化矩阵。LedoitWolf 不走这条常数相关目标。
import numpy as np
import pandas as pd


def constant_correlation_shrink(history: pd.DataFrame, delta: float = 0.5):
    """保留样本方差。非对角收到平均相关乘两条标准差。δ 是指定的,不是最优强度。"""
    sample = history.cov(ddof=1).to_numpy(dtype=float)
    vol = np.sqrt(np.diag(sample))
    corr = history.corr().to_numpy(dtype=float)
    mask = ~np.eye(corr.shape[0], dtype=bool)
    rho = float(corr[mask].mean())
    target = np.outer(vol, vol) * rho
    np.fill_diagonal(target, vol**2)
    mixed = (1.0 - delta) * sample + delta * target
    frame = pd.DataFrame(mixed, index=history.columns, columns=history.columns)
    return frame, rho


idx = pd.to_datetime(["2024-01-02", "2024-01-03", "2024-01-04", "2024-01-05"])
frame = pd.DataFrame(
    {
        "A": [0.01, 0.02, 0.03, 0.50],
        "B": [0.02, 0.01, 0.00, 0.50],
        "C": [0.03, 0.00, -0.03, 0.50],
    },
    index=idx,
)
session = idx[-1]
# 决策日当天的 0.50 留在表里,就是为了核对 loc 之后再丢掉最后一行。
history = frame.loc[:session].iloc[:-1]
shrunk, rho = constant_correlation_shrink(history)
before = history.cov(ddof=1).to_numpy(dtype=float)
eig_before = float(np.linalg.eigvalsh(before).min())
eig_after = float(np.linalg.eigvalsh(shrunk.to_numpy(dtype=float)).min())
leaked = frame.cov(ddof=1).to_numpy(dtype=float)
print("shrink_rows", len(history))
print("shrink_rho", f"{rho:.10f}")
print("shrink_ab", f"{float(shrunk.loc['A', 'B']):.10f}")
print("shrink_ac", f"{float(shrunk.loc['A', 'C']):.10f}")
print("shrink_bc", f"{float(shrunk.loc['B', 'C']):.10f}")
print("shrink_eig_before", f"{eig_before:.3e}")
print("shrink_eig_after", f"{eig_after:.10f}")
print("shrink_leak_differs", int(not np.allclose(leaked, before)))
# 工业库对照。自带同一张宽表,单独运行也不依赖上一块。
# LedoitWolf 向缩放单位阵收缩,默认环境不安装 scikit-learn。
import pandas as pd

idx = pd.to_datetime(["2024-01-02", "2024-01-03", "2024-01-04", "2024-01-05"])
panel = pd.DataFrame(
    {
        "A": [0.01, 0.02, 0.03, 0.50],
        "B": [0.02, 0.01, 0.00, 0.50],
        "C": [0.03, 0.00, -0.03, 0.50],
    },
    index=idx,
)
history = panel.loc[: idx[-1]].iloc[:-1]
try:
    from sklearn.covariance import LedoitWolf
except ImportError:
    print("ledoit_wolf", "skipped")
else:
    fitted = LedoitWolf().fit(history.to_numpy(dtype=float))
    print("ledoit_wolf_shrinkage", f"{float(fitted.shrinkage_):.4f}")
真实案例
案例 1:平静窗口里的 9.78%
2020-02-19 之前,60 日样本波动 9.78%,指数加权 11.23%。到 2020-03-23,种子里的 SPY 复权价跌了 33.70%。French 月频上,2020-02 与 2020-03 的 Mkt-RF 复利是 −20.41%,只有两个月,而且是超额因子,不是上面那条复权价。两个数字回答不同的问题:日频路径说价格跌了多少,月频因子说超额收益在这两个月里复利是多少。波动模型若只用下跌前的 60 天,两个问题都接不住。
个人账户的含义:仓位上限和回撤开关(M04,杠杆上限见 ../../../docs/risk_policy.md)不是波动预测的替代品。预测停在 11% 时,上限仍然要先写好。
案例 2:2022 年做多市场、做空 HML
2022 年 Mkt-RF 复利 −20.99%,HML 复利 +31.74%,与 M07 的五因子文件一致。把两条月收益逐月相减再复利,得到 −43.04%。把两个全年复利直接相加得到 −52.73%,那不是这条多空的净值。
这条组合要做空价值腿。只做多、杠杆上限 1.0 的账户记不到 −43.04%。36 个月相关从 0.26 降到 0.05,并没有变成 −1。亏在两条因子当年的实现,不在「相关系数突然估计成了 −0.08 所以必须重写矩阵」。12 个月的 −0.0752 留在样本描述里,不进入下一季的 F。
案例 3:2008 年秋的市场超额,和 2025 年的未建模挤兑
2008-09 至 2009-03,Mkt-RF 七个月复利 −36.55%。一个 βₚ = 0.98 的组合,因子部分会跟着市场超额走,特质部分解释不了这段。压力测试至少要重放这段月收益,而不是只报一个全年波动。
2025 年夏季的 −4.2% 是经纪商客户样本。轧空不在行业哑变量里。风险模型的输出是「在你写下的 X 里,方差怎么分」;没写下的列,分解结果里不会出现。
方法论来源
| 概念 / 模型 | 核心文献或规范出处 |
|---|---|
| 一致性风险度量 | Artzner, Delbaen, Eber & Heath (1999), Mathematical Finance 9(3) |
| 协方差收缩 | Ledoit & Wolf (2003), Journal of Empirical Finance 10(5);2004 年 JPM 30(4) 与 Journal of Multivariate Analysis 88(2) |
| 特征值调整 | Menchero, Orr & Wang 的 USE4 笔记。本章的 0.0325 与 0.0175 不是那套偏差函数 |
| Newey–West | Newey & West (1987),Bartlett 核 |
| 结构化风险 | Rosenberg (1974), JFQA 9(2) |
| 本仓库协方差 | CovarianceModel:窗口止于交易日之前,样本协方差,乘 252 |
| 图 | figures/M11/plot_risk_model.py |
💡 思考回顾与巩固
核心认知纠偏
| 误区 | 反例 | 用法 |
|---|---|---|
| 95% VaR 加得起来 | 两只债券各自的 VaR 是 0,合在一起是 100 | 次可加性用波动或期望短缺来要求 |
| 500 只股票就该用 500×500 的样本协方差 | 125250 个参数;X 已知时教学计数是 653 | 观测盖不住非对角元 |
| 等权就是风险各半 | 30% 与 20%、相关 0.5 时,份额是 63.16% 和 36.84% | RC 加总等于 σₚ |
| 特质贡献相同就说明两只股票一样 | 0.003600 一只来自权重大,一只来自特质波动大 | 把权重和波动分开看 |
| 纯因子组合自动美元中性 | (0.5, 0.5, 0) 的权重和是 1 | 中性只针对其他因子 |
| Newey–West 会把风险一律上调 | 同一段里市场的长程比是 0.59,HML 是 1.49 | 单月模型仍用单月协方差 |
| 指数加权能提前看到 2020 年 3 月 | 11.23% 对 9.78%,路径仍是 −33.70% | 仓库用的是样本协方差 |
| δ = 0.5 就是 Ledoit–Wolf | 0.5 是指定的,条件数 9.32 来自正态面板 | 不调用未安装的库 |
LedoitWolf 会复现常数相关矩阵 |
它的默认目标是缩放单位阵;第 12 节的非对角是另一套公式 | 可选库没装上时,对照块降级并打印 skipped |
| 2022 年相关变成了 −1 | 36 个月相关从 0.2618 到 0.0510;12 个月是 −0.0752 | 12 个点不重写 F |
| 把 −20.99% 和 +31.74% 相加就是多空净值 | 逐月相减再复利是 −43.04% | 全年复利不能相加 |
| 做空 HML 的 −43% 是个人账户的回撤 | 只做多、杠杆上限 1.0 做不出这条空头 | 研究组合和账户分开 |
费曼自测
- 为什么波动率被留下做拆分,即使它不描述左尾?
- 风险贡献 0.1376 和 0.0803 加起来为什么不是 1?
- 长程方差比单月方差小的时候,把月方差乘 12 会怎样?
- 2022 年 HML 大涨、市场大跌,为什么不能据此说 36 个月相关已经反转?
自测要点
1. w′ Σ w 的每一项能指回因子或个股,优化才有梯度。VaR 的反例说明它不能当这种加总。左尾用压力路径看:2008 年那段 −36.55% 的市场超额,2020 年种子里 −33.70% 的复权价。 2. 定义 RCᵢ = wᵢ(Σ w)ᵢ / σₚ 时,加总等于波动 0.2179。63.16% 和 36.84% 才是份额。两个数都要报,避免把 0.1376 读成 13.76% 的资金比例。 3. 市场在 2012–2021 的长程比是 0.59。乘 12 会高估这段求和的方差。HML 的 1.49 则是低估。方向跟着自相关走。一个月的持有期不用这个长程比去改 F。 4. 截至 2022-12 的 36 个月相关是 0.0510,仍为正,只是比 2021-12 的 0.2618 更接近 0。−0.0752 是单独 12 个月。当年的亏损来自两条收益的实现和做空价值腿,不是来自一个已经估计稳定的新相关。四维习题
A. 概念题
- 写出 Σ = XFX′ + Δ,并说明 X 已知和 X 也要估计时,参数个数差在哪里。
- 95% VaR 的两债券例子里,哪个数破坏了次可加性?
- 纯因子权重 (0.5, 0.5, 0) 中性了什么,没有中性什么?
- 为什么
volatility.py不用指数加权?
B. 计算题
- 重算两只股票的 σₚ、两条风险贡献和份额。
- 重算三只股票的 βₚ、方差四块和 23.23% 的组合波动。
- 500 只股票、17 个已知暴露的因子,协方差参数是多少?样本协方差是多少?
- 用 2012–2021 与 2022 的打印结果,说明为什么不能把 12 个月相关写进 F。并计算逐月相减的 2022 复利与两个全年复利之和相差多少。
- 第 12 节的三行历史,平均相关是多少?δ = 0.5 时 AB、AC、BC 的收缩协方差是多少?为什么最后一行的 0.50 不能进窗口?
LedoitWolf和这张矩阵是同一个估计量吗?
C. 编程实战题
- 运行
figures/M11/plot_risk_model.py,核对 0.2179、0.5769、秩 3、纯因子权重和 SPY 的 −0.3370。 - 把三只股票的特质波动对调后重算份额,看「高波动一定占大头」是否还在。
- 写一个窗口在
session之前结束的 60 日波动函数,并在注释里说明为什么不能把当天收益放进去。
D. 个人实战思考题
- 你的持仓只有 15 到 25 只,只做多。653 这个参数计数和两只股票的 63:37 哪一个先用得上?
- 压力测试清单里,2008-09 至 2009-03、2020-02-19 至 2020-03-23、2022 年做多市场做空 HML,哪几条是你的账户真的可能经历的路径?
- 若一个风格不在 X 里,风险贡献报告会把它显示成什么?
完整参考答案与解析
**A1.** Σ = XFX′ + Δ。X 已知时,自由参数是 F 的 K(K + 1) / 2 和 Δ 的 N 个对角。K = 17, N = 500 时是 653。X 若由回归估计,再加 NK = 8500,合计 9153。样本协方差始终是 125250。653 这个数依赖「17 个暴露已经给定」。 **A2.** 单只 95% VaR 为 0,因为损失为 0 的概率是 0.96。两只都平安的概率是 0.9216,组合 VaR 为 100。0 + 0 < 100。 **A3.** 对行业 B 的暴露是 0,对行业 A 的暴露是 1。权重和是 1,市场方向和美元中性都没有被约束。特质方差也还在。 **A4.** 样本协方差乘 252,窗口在交易日之前结束,每一步都能对上冻结的收益。指数加权要再选 λ。2020 年 2 月的对照里,0.94 只把预测从 9.78% 改到 11.23%,没有覆盖随后的价格路径。 **B5.** σₚ² = 0.0475,σₚ = 0.2179。风险贡献 0.1376 与 0.0803。份额 0.6316 与 0.3684。 **B6.** βₚ = 0.98。四块是 0.031117、0.015625、0.003600、0.003600。和为 0.053942,波动 0.2323。市场占 0.5769。 **B7.** 因子协方差 153,特质方差 500,合计 653。样本协方差 125250。少掉的是非对角元里那些没有结构约束的项,不是「估计误差消失了」。 **B8.** 120 个月的相关是 0.1446,波动 13.64% 与 10.51%。2022 年只有 12 个月,相关 −0.0752,波动 23.19% 与 19.14%。36 个月相关从 0.2618 到 0.0510。逐月相减再复利是 −0.4304。两个全年复利相加是 −0.2099 − 0.3174 = −0.5273。相差 0.0969,因为全年复利不能代替逐月相减。 **B9.** 平均相关是 −1 / 3。收缩后 AB 是 −0.0000666667,AC 是 −0.0002000000,BC 是 0.0001000000。0.50 在决策日当天,`loc[:session].iloc[:-1]` 会把它丢掉;放进去会改协方差。`LedoitWolf` 的默认目标是缩放单位阵,强度也另估,不是这张常数相关矩阵。 **C10–C12.** 与 `figures/M11/plot_risk_model.py` 同一契约。样本协方差秩 3。δ = 0.5 后最小特征值 0.232654,条件数 9.32,面板是种子 7 的正态数,不是股票。纯因子权重 0.5、0.5、0。SPY 路径 −0.3370,60 日波动 0.0978,指数加权 0.1123,其后 23 日的年化样本波动 0.7663。Mkt-RF 在 2008-09 至 2009-03 为 −0.3655,在 2020-02 至 2020-03 为 −0.2041。 对调特质波动会改变 0.015625 和两个 0.003600 的位置。权重平方还在,所以高波动若配上很小的权重,特质贡献仍然可以不大。因子一块只跟 βₚ 走,对调特质波动不会改变 0.031117。 **D13.** 先用得上的是 63:37 这种几只股票上的风险贡献。15 到 25 只股票的样本协方差仍然容易病态,但 500 只股票的 653 不是这个账户的参数表。行业暴露可以用你实际持有的行业计数,不必凑满 11 个。 **D14.** 复权价的 −33.70% 和 2008 年的市场超额,是只做多也会碰到的市场路径;账户的跌幅还取决于当时的仓位,不会自动等于这两个数。−43.04% 要做空 HML,本轮杠杆上限 1.0 且只做多时,这条不是账户净值。它可以作为「若价值腿是空头,2022 年会怎样」的研究情景。 **D15.** 它会留在特质项里,或者渗进已有的行业和风格列。报告不会单开一行叫「轧空」。M00 的 −4.2% 因此不会被 HML 中性自动解释掉。📌 章节知识总结
一句话核心洞察
- 波动率用来拆分。95% VaR 在两债券例子里是 0 加 0,组合却是 100。
- 三只股票的教学账上,市场占方差 57.69%,组合波动 23.23%。等权两只股票的风险份额是 63.16% 对 36.84%。
- 单月协方差不被 Newey–West 改写。2012–2021 市场的长程比是 0.59,HML 是 1.49。
- 仓库的估计器是决策日之前的样本协方差乘 252。2020-02-19 之前的 9.78% 和 11.23% 都没有覆盖随后 −33.70% 的复权价路径。
- 2022 年做多市场、做空 HML 的月频复利是 −43.04%。36 个月相关只是从 0.26 附近降到 0.05。只做多的账户做不出这条空头。
- 三行教学面板的平均相关是 −1 / 3。δ = 0.5 的常数相关收缩把 AB 收到 −0.0000666667,最小特征值从 0 附近升到 0.0000243938。
公式与样本
| 对象 | 表达式或数值 | 前提 |
|---|---|---|
| 模型 | Σ = XFX′ + Δ | Δ 对角,表示共同部分已进 X |
| 500 只、17 个已知因子 | 653 对 125250 | 17 是教学计数 |
| 两债券 VaR | 0 与 100 | 违约概率 4%,独立,95% 分位 |
| 两股票 | 波动 0.2179;份额 0.6316、0.3684 | 波动 30%、20%,相关 0.5,等权 |
| 三股票 | 方差 0.053942,波动 0.2323,市场占 0.5769 | 市场波动取 18% 的整数 |
| 纯因子 | 权重 (0.5, 0.5, 0) | Δ = I,两行业 |
| 加权因子收益 | 0.026000 | 收益 0.01 与 0.03,特质方差 0.04 与 0.01;等权是 0.020000 |
| 特征值调整 | 0.0325 与 0.0175 | 从 0.0400 与 0.0100 向均值 0.0250 收一半;条件数 1.8571 |
| 状态调整 | 波动 30.47% | 因子块乘 2.25;特质不乘;27% 是教学输入 |
| 收缩 | 最小特征值 0.233,条件数 9.32 | δ = 0.5,种子 7,不是股票 |
| 常数相关面板 | 平均相关 −1 / 3;非对角 −0.0000666667、−0.0002、0.0001 | 窗口丢掉当天的 0.50;收缩后最小特征值 0.0000243938 |
| 长程比 | 市场 0.59,HML 1.49 | 2012-01 至 2021-12,滞后 4 |
| 2022 多空 | −43.04% | 月频 Mkt-RF 减 HML,要有空头 |
| 36 个月相关 | −0.7240(1983-10),0.6711(2011-10) | French 月频 |
| SPY 路径 | −33.70% | 种子复权价,2020-02-19 至 03-23 |
| 2008 年市场超额 | −36.55% | 2008-09 至 2009-03,七个月 |
跨模块
| 结论 | 交给 | 位置 |
|---|---|---|
| 残差波动是 Δ 的对角,不是总波动 | 预测公式里的 σ | M10 |
| 样本协方差、窗口在交易日之前 | 仓位波动 | ../../../src/quant/risk/volatility.py |
| 杠杆上限 1.0,做不出 −1 倍 HML | 压力情景与账户分开 | M04,../../../docs/risk_policy.md |
| 2022 年 −20.99% 与 +31.74% | 因子实现 | M07 |
| 2025 年夏季约 −4.2% | 未写进 X 的挤兑 | M00 案例 4 |
| 风险贡献进入权重 | 组合构建 | M12 |
| 把贡献记到因子上 | 归因 | M14 |
学习指引
概念卡片:结构化风险模型
- 精读:GK 第 3 章怎样把组合方差拆成共同因子和残差。因子 7.2 的构建顺序是暴露、因子收益、特质方差。
- 对照:参数个数、风险贡献和 2022 年复利以本章脚本为准。USE4 的方法笔记只说明业界模型长什么样,不把他们的输出当成个人账户的风险。
- 项目:持仓的波动用决策日之前的窗口。压力清单写明哪一条需要空头。不把 12 个月的相关覆盖进 F。
- 下一步:M12 在杠杆上限和行业上限之内,用 M10 的 α 和本章的 Σ 决定权重。
自检清单
- 能手算两债券的 VaR:0 与 100,以及 0.9216
- 能把三只股票的方差拆成 0.031117 和三块特质,并得到 23.23%
- 能说明风险贡献 0.1376 与 0.0803 加总等于 0.2179,份额才是 63% 对 37%
- 能解释长程比 0.59 和 1.49 方向相反
- 能把 SPY 的 −33.70% 说成种子复权价,并把 −43.04% 说成需要空头的研究组合
- 能指出仓库估计器不含指数加权,窗口在交易日之前结束
- 能用
loc[:session].iloc[:-1]说明当天的 0.50 不进协方差,并手算平均相关 −1 / 3