M08 因子陷阱与研究现状
层级:L2 因子投资 | 优先级:★★★ | 预计学时:12 小时 对应原书:因子第 6 章(6.1–6.7);黑箱第 9 章的检验、第 11 章;陈 3.4 前置知识:M01 的 t = SR √Y;M06 的复制率口径;M07 的窗口表。 读书笔记:因子第 6 章的陷阱 状态:reviewed 数据截至:2026-08|最近复核:2026-10-22
学习目标
- 用期望的线性说明:1000 次水平为 5% 的独立检验,在全是噪声时平均会「显著」50 次。
- 手算 20 个 p 值上的 Bonferroni、Holm 和 Benjamini–Hochberg,并看出三者停在不同的个数。
- 把 t = 3 换算成不同样本长度下的年化夏普门槛,并把它和本仓库现行流程里的门槛分开。
- 读懂 20,000 次模拟:200 条零溢价、十年样本里,最大夏普的均值是 0.868,不是把任何夏普乘上 0.42。
- 把「原论文能否复现」「更严的持仓设定下还显著吗」「发表后的月均掉了多少」分成三件不同的事。
- 在月频上算出一组 Deflated Sharpe:年化夏普 1.20、T = 120、M = 100、截面标准差 0.12 时,相对 0 的概率是 0.999555,紧缩后是 0.659086。
- 用 4 个时间分块的 6 种组合,算出样本内冠军落入样本外后半区的比例 0.666667。
本章知识拓扑图
flowchart TB
    TRY["同一份数据上的多次尝试"] --> MAX["被留下的是最大的 t 或夏普"]
    MAX --> HURDLE["门槛要跟着尝试次数上移"]
    HURDLE --> HLZ["HLZ:新因子 t 大于 3"]
    HURDLE --> DSR["DSR:月频夏普对选择门槛的概率"]
    DSR --> PBO["CSCV:样本内冠军的样本外名次"]
    HURDLE --> GATE["本轮流程:不把夏普大于 1 写成通用门槛"]
    PUB["发表时的月均"] --> DECAY["样本外与发表后的下降"]
    DECAY --> WINDOW["同一列因子的后一段窗口"]
    CROWD["同质持仓"] --> UNWIND["被迫减仓时的联动"]
    WINDOW --> ACCT["做多、杠杆上限 1.0 的账户"]
    UNWIND --> ACCT
多次尝试改变的是「你留下来的那个数」的分布。它不自动把 French 因子的月均乘上一个固定折扣。
🟢 入门层:好看的回测从哪来
1. 五十次「显著」可以一个真溢价都没有
设每次检验在原假设为真时,以概率 α 拒绝原假设。做了 m 次,假阳性个数的期望是
E[Σⱼ₌₁^m Iⱼ] = Σⱼ₌₁^m E[Iⱼ] = mα
| 符号 | 含义 |
|---|---|
| Iⱼ | 第 j 次检验被拒绝时为 1 |
| α | 单次检验的水平,本章例子用 0.05 |
| m | 尝试次数,包括没有写进备忘录的那些 |
这个等式只用到期望的可加性。检验之间相关,期望个数仍然是 mα。相关改变的是另一件事:这些拒绝会不会挤成同一主题的很多副本,以及最大的那个 t 值有多极端。相关不会把期望个数从 50 改成 5。
手算:m = 1000,α = 0.05。
1000 × 0.05 = 50
若 1000 个信号的真实溢价都是 0,你平均仍会看到 50 个「5% 显著」。只把这 50 个写进结论,读者看到的动物园里没有那些不显著的 950 个。Cochrane (2011, JF 66(4)) 用「因子动物园」描述已经发表的这一层。Harvey, Liu & Zhu (2016, RFS 29(1)) 清点了 313 篇文章里的 316 个因子,并写明这个清点低于真实尝试次数:没发表的失败测试看不到。他们的判断是,已发表结论里有很多会是假的,新因子需要 t 统计量大于 3.0。3.0 是他们那套多重检验框架下的建议,不是「把 1.96 机械改成 3」的本仓库门禁。
2. 个人账户比论文多一道筛选
论文至少留下了因子的定义。个人研究常常只留下夏普最高的那次参数。docs/workflow.md 开头写明:本轮不使用「夏普大于 1」作为通用门槛。同页的清单要求记录尝试次数。实验模板 research/templates/experiment_template.md 已有「尝试过的参数组合数」一栏。这一栏要计入放弃的规格。只记最后一次,等于把 m 写成 1。
M01 的对照仍然有效:三年、夏普 1.5,t = 1.5 √3 = 2.60;二十年、夏普 0.6,t = 0.6 √20 = 2.68。两个 t 值接近。二十年跨过的制度更多,先验上更值钱。单看 t 值会把短样本的高夏普和长样本的普通夏普当成同等证据。
🟡 进阶层:三种门槛和一次零溢价模拟
3. Bonferroni、Holm 和错误发现率
Bonferroni 是洁癖标准:一整批检验里,连一个假货都不许漏进结论,临界值按次数收紧。 Benjamini–Hochberg 是质检抽查:允许按比例残留假货,控制的是假发现占拒绝次数的期望。 相关不改变「水平 5%、全是噪声时期望有 5% 显著」这件事。它改变的是你会不会同时看见一大片显著。 个人研究日志里的 m 含放弃的规格。只报告夏普最高的一组,不能把 m 写成 1。
记排序后的 p 值为 p₍₁₎ ≤ … ≤ p₍ₘ₎,水平 α = 0.05。
| 方法 | 控制的对象 | 规则 |
|---|---|---|
| Bonferroni | 至少一次假阳性的概率 | 每个 p 与 α/m 比 |
| Holm (1979) | 同一个族错误率,逐步放宽 | 第 k 个要过 α / (m − k + 1),第一次失败就停止 |
| Benjamini–Hochberg (1995) | 假阳性在「被拒绝的那些」里的期望比例 | 最大的 k 使 p₍ₖ₎ ≤ α k/m |
Benjamini & Yekutieli (2001) 在检验相关时使用更严的临界值。Harvey、Liu 与 Zhu 的附录里,BHY 在 5% 水平对应的 t 门槛约为 3.05,和他们正文的「大于 3.0」同一量级。本章手算用的是独立情形的 BH,不是 BHY。
20 个 p 值:0.001、0.004、0.012、0.02、0.03,其余 15 个都是 0.11。
Bonferroni 的临界值是 0.05/20 = 0.0025。只有 0.001 小于它。
Holm 的前两步:
0.05/20 = 0.0025, 0.001 ≤ 0.0025
0.05/19 = 0.002632, 0.004 > 0.002632
第二次失败,停止。仍然只有第一个被拒绝。
BH 的前三步临界值是 0.05/20 = 0.0025、0.10/20 = 0.005、0.15/20 = 0.0075。0.001 和 0.004 都过了各自的临界值,0.012 没有。最大的 k 是 2。BH 拒绝前两个,Holm 只拒绝第一个。错误发现率允许「被拒绝的集合里有一小部分是假的」,所以同样的 p 值可以多留一个。把 BH 的结果说成「族错误率也控制在 5%」就不对了。
独立正态、双侧、族错误率 5% 的 Bonferroni 临界 t,以及 √(2 ln m) 这个最大次序统计量的首项,随 m 增长:
| m | Bonferroni 临界 ‖t‖ | √(2 ln m) |
|---|---|---|
| 1 | 1.960 | — |
| 20 | 3.023 | 2.448 |
| 100 | 3.481 | 3.035 |
| 316 | 3.778 | 3.393 |
316 次独立检验若要把「至少误拒一次」的概率压在 5%,临界值是 3.78,高于 Harvey、Liu 与 Zhu 的 3.0。他们的 3.0 允许因子之间相关,也不是这张独立 Bonferroni 表。相关越强,有效的独立检验次数越少,独立 Bonferroni 就越严。JKP 把因子收成主题,罚的就是「同一主题算成几百次独立测试」。
4. t 大于 3 对应多高的夏普
M01 在收益独立、夏普用样本标准差时有
t = SR × √Y
Y 是样本里的年数。月频因子用 Y = T/12,日频回测用 Y = n/252。两边不要混。原假设下、自相关为 0 时,年化夏普估计量的标准误大约是 1/√Y。这是 Lo (2002) 公式在夏普为 0 时的特例,不是对一个已经很高的夏普再做的标准误。
由此
SRₜ₌₃ = 3/√Y, SR_(t=1.96) = 1.96/√Y
| 年数 | t = 1.96 对应的夏普 | t = 3 对应的夏普 |
|---|---|---|
| 5 | 0.877 | 1.342 |
| 10 | 0.620 | 0.949 |
| 20 | 0.438 | 0.671 |
| 50 | 0.277 | 0.424 |
手算十年、t = 3:√10 = 3.162,3/3.162 = 0.949。同一段样本上,t = 1.96 只要求夏普 0.620。从 2 提到 3,十年样本的夏普门槛上升约 0.33,不是把回测夏普乘以 ½。
五年样本若坚持 t > 3,夏普要到 1.34。Harvey、Liu 与 Zhu 的 3.0 是对着几十年的截面研究说的。把它抄到五年个人回测上,经济含义已经变了。本轮流程没有把这个换算写成准入线。docs/workflow.md 里历史表上的「样本外夏普大于 1」也标明是长期参考,不是本轮通用门槛。
5. 两百条零溢价策略
首项近似:m 个独立标准正态的最大值,量级是 √(2 ln m)。十年样本、标准误 1/√10 = 0.3162、m = 200:
ln 200 = 5.2983, 2 ln 200 = 10.5966, √(2 ln 200) = 3.255
0.3162 × 3.255 = 1.029
这是量级,不是期望本身。极值分布还要再减一项,首项因此偏高。脚本用种子 7 做了 20,000 次:每次 200 个独立的 N(0, 0.3162²) 年化夏普,记录其中的最大值。
| 量 | 数值 |
|---|---|
| 最大夏普的均值 | 0.868 |
| 最大夏普的 95% 分位 | 1.097 |
| 至少有一条夏普超过 1 的实验比例 | 14.5% |
| 单格夏普超过 0.5 的频率 | 5.7% |
| 200 格里超过 0.5 的期望条数 | 11.42 |
同一脚本在这 20,000 次之后,再抽了一次日频样本:200 条策略、2520 天、日收益均值真为 0、夏普用样本标准差乘 √252。这一次的最大夏普是 0.969,超过 1 的条数是 0,超过 0.5 的条数是 11。一次抽样的 0 条,不能推翻 14.5% 的实验里至少会出现一条夏普超过 1。排名以 20,000 次的分布为准。
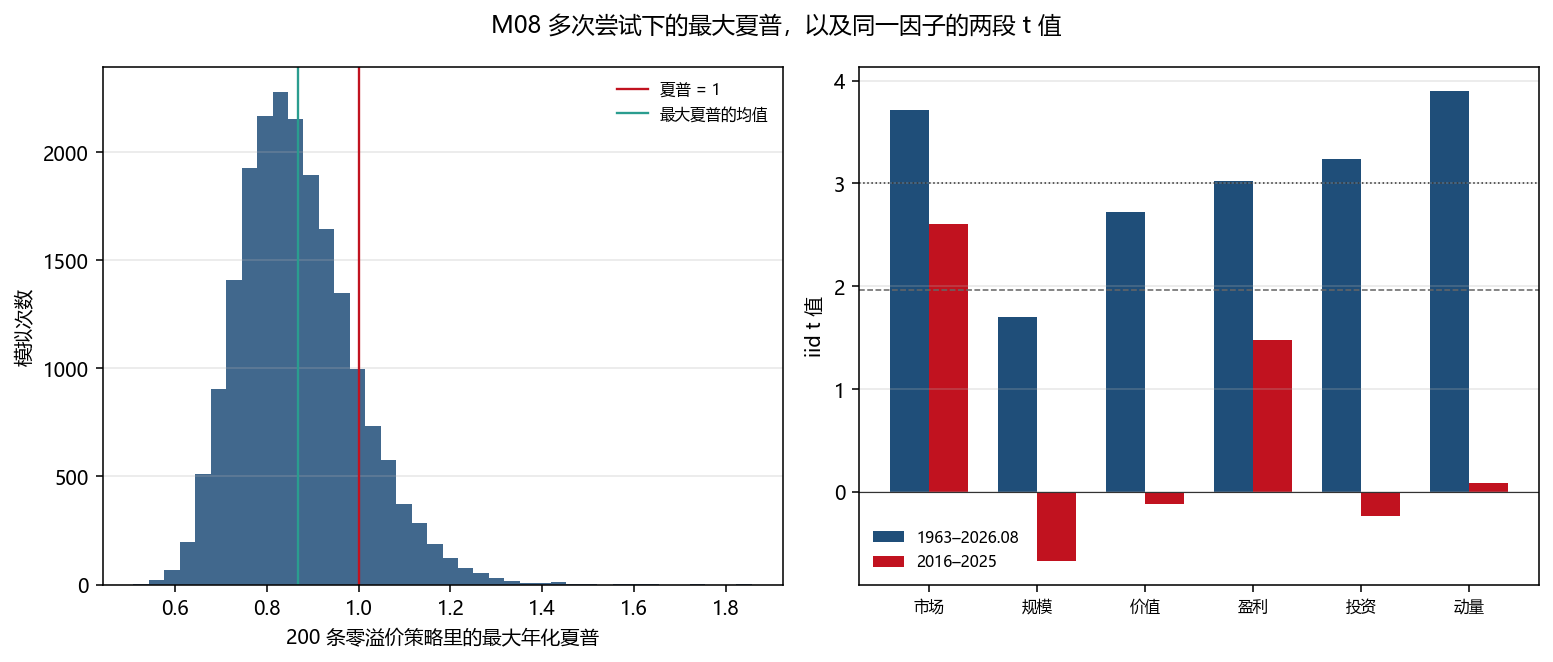
Bailey & López de Prado (2014, JPM 40(5)) 的 Deflated Sharpe 把尝试次数、样本长度、偏度和峰度放进「真实夏普是否还高于选择门槛」的概率。第 10 节在月频上把它算完。上表仍是零溢价、正态、独立情形下最大夏普的模拟,用来看最大值的分布,不代替那一个概率。Harvey & Liu (2015, JPM) 的回测折扣也随尝试次数上升。折扣不是固定的五成,更不是下文 McLean 与 Pontiff 的 58%。
import math

import numpy as np


def null_max_sharpe(n_exp: int = 20_000, n_strat: int = 200, years: float = 10.0) -> np.ndarray:
    """零溢价策略的最大年化夏普。均值设为 0,才是「没有溢价」的原假设。

    标准误用 1/√年数,对应独立收益、真实夏普为 0。这不是把某次回测结果打折。
    """
    rng = np.random.default_rng(7)
    se = 1.0 / math.sqrt(years)
    draws = rng.normal(0.0, se, size=(n_exp, n_strat))
    return draws.max(axis=1)
6. 三篇「复制」论文问的不是同一句话
| 论文 | 他们问的话 | 本章采用的原句 |
|---|---|---|
| Harvey, Liu & Zhu (2016, RFS 29(1)) | 在已经发表了 316 个因子之后,新因子的 t 要多高 | 大于 3.0。316 低于真实尝试次数,门槛可能更高 |
| Hou, Xue & Zhang (2020, RFS 33(5)) | NYSE 断点、市值加权之下,异象的高减低还显著吗 | 452 个里 65% 的 ‖t‖ 不到 1.96;交易摩擦一类 96% 不到;门槛 2.78 时失败率 82% |
| Chen & Zimmermann (2022, Critical Finance Review 11(2)) | 沿原论文的做法,t 值能不能再现 | 319 个特征。原文明确显著的 161 个里,98% 的复现多空 t 大于 1.96。复现 t 对原文 t 的斜率 0.90,R² = 83% |
| Jensen, Kelly & Pedersen (2023, JF 78(5)) | 换一种「复现」的定义,比例是多少 | 可比的美国原始收益口径 55.6%;他们偏好的贝叶斯全球口径 82.4%。13 个主题里 11 个的贝叶斯复制率高于 50%,例外是低杠杆和规模 |
98% 说的是:按原论文的股票池和加权,t 值可以再算出来。65% 说的是:换成更接近可投资的市值加权之后,很多原结果不再显著。55.6% 和 82.4% 的分母也不相同。四句话可以同时为真。不能收成「因子要么都能复制,要么都是假的」。
Feng, Giglio & Xiu (2020, JF 75(3)) 问的是下一条:控制了一大组已有因子之后,新因子还有没有增量。很多新因子在这一关上是冗余的。增量例子不写成「只剩盈利」这种名单。M07 已经算过一件相关的事:HML 对 CMA 的斜率约等于 1,月截距的 t 值是 −0.28。那是增量检验的一个例子,不是 Feng 等人的输出。
7. 发表后下降的 26% 和 58% 是预测变量的收益
McLean & Pontiff (2016, JF 71(1)) 研究 97 个预测变量。原样本结束到发表之前,收益下降约 26%。发表之后,下降约 58%。他们把多出来的大约 32 个百分点联系到读者按论文去交易。下降在更容易套利的股票里更明显。
这两个百分比是那 97 个预测变量的平均收益相对原文样本的降幅。它们不是:
- 任何一条策略的夏普都乘以 1 − 0.58;
- French 的 HML 或 Mom 已经按 58% 衰减过;
- 个人回测在扣成本之前先打五折的规则。
Novy-Marx & Velikov (2016, RFS 29(1)) 按换手给异象分类,说明成本对高换手的实现是一阶的。港股印花税买卖双方各 0.1% 的量级见 M00。月换仓的学术多空,在个人账户上要先过这一项,再谈 58%。
🔴 深入层:衰减、拥挤和流程
8. 先验写在看数之前
统计门槛拦的是「噪声里的最大值」。它不提供经济方向。看完数据再补故事,故事会跟着最大的那个 t 值走。实验目录里的假设要先写预期方向和窗口,再跑。M03 的前视和滚动挑选,是同一条纪律在数据时点上的版本。
行为上的持续可以来自套利限制:借不到券、资金期限短、噪声交易者把价格推得更远。Baker & Wurgler (2006, JF 61(4)) 发现,高情绪时期之后,小盘、年轻、高波动、不盈利这一类股票的随后收益更低。这是他们的样本结论,不是一条可以每月切换的情绪开关。本章不把情绪指数接进下单。
一个因子上线之后表现差,至少分开三件事:路径仍落在回测的回撤分布里;月均相对发表时下降,但定义还在;制度变了,定义本身不再对应原来的交易。M01 已经说明夏普的估计误差大。六个月的亏损很少能够单独做成一次 t 检验。M04 的单位净值闸门处理的是账户能不能继续扛,不是用六个月数据宣布因子死亡。
9. 本轮流程里已经写下的,和本章不改的
| 动作 | 位置 | 本章的用法 |
|---|---|---|
| 记录尝试次数,含放弃的规格 | docs/workflow.md 清单;实验模板第 4 节 |
m 用这个数,不用 1 |
| 本轮不用「夏普大于 1」做通用门槛 | docs/workflow.md 开头 |
t > 3 同样不写回去 |
| 时间切分,测试段只用一次 | 同页清单 | 挑选发生在测试段之外 |
| 同时报告预先写定的窗口和后一段 | 本章清单新增的一句 | 对上 M07 的 2016–2025 |
基本面量化是把已经有经济方向的规则写成可检验的信号,再用上面的 m 和窗口去压它。方向来自主观经验,不免除前视和成本。事件和公告日上的检验留在后面的专题,不把月频因子的 t 值挪过去。
10. Deflated Sharpe:门槛、偏度和峰度进同一个概率
PSR 是只和 0 比的及格率。100 次尝试里,瞎蒙也能摸到一条最高分,那条最高分的期望就是门槛 SR₀。 扣掉这道门槛、再计入偏度和厚尾之后,同一条标准误上的概率从 0.999555 降到 DSR 0.659086。 下降主要来自选择,不是把夏普乘上一个固定折扣。0.659086 也不是本轮准入线。 年化夏普 1.20 已经乘过 √12,不能再和月数 120 放进同一条标准误。
第 5 节的模拟回答的是:零溢价、正态、独立时,最大年化夏普的分布在哪里。Deflated Sharpe Ratio(Bailey & López de Prado, 2014, JPM 40(5))回答的是另一句:你挑出来的那一条,真实夏普超过「多次尝试造成的门槛」的概率有多大。两句不要合成一个折扣。
夏普、门槛和标准误都用与收益相同的频率,这里是月。年化夏普 1.20 先换成月夏普
ˆSR = 1.20/√12 = 0.346410
再进入下面三步。把 1.20 和 T = 120 直接代进标准误,等于把年化尺度的夏普和月频的期数乘在一起。
第 1 步。 M 次独立试验下,标准正态最大值的期望用 Euler–Mascheroni 常数近似。本章把 γ 固定为 0.5772156649,不再加更长的尾数。
Z₀ = (1 − γ) Φ⁻¹(1 − 1/M) + γ Φ⁻¹(1 − 1/(Me))
M = 100 时,1 − 1/M = 0.99,Me = 271.828183,1 − 1 / (Me) = 0.996321。对应的分位数是 2.326348 和 2.680210。加权之后
Z₀ = 2.530603
尝试集合的月夏普截面标准差记为 σ_({ˆSR})。本例给定 0.12,它描述 100 条尝试彼此差多远,不是选中那一条自己的标准误。基准门槛
SR₀ = 0.12 × 2.530603 = 0.303672
第 2 步。 选中策略的夏普估计还有自己的标准误。ˆγ₃ 是收益的矩偏度,ˆγ₄ 是 Pearson 峰度,正态参照是 3,不是超额峰度 0。
ˆSE(ˆSR) = √((1 − ˆγ₃ ˆSR + ((ˆγ₄ − 1) / 4) ˆSR²) / (T − 1))
T = 120,偏度 −0.5,Pearson 峰度 5.0。因为 (1.20)² / 12 = 0.12,分子是
1 + 0.5 × 0.346410 + 0.12 = 1.293205
正态、偏度为 0、峰度为 3 时,分子只到 1 + 0.5 × 0.12 = 1.06,标准误是 0.094380。负偏和厚尾把它抬到
ˆSE = √(1.293205/119) = 0.104246
峰度若误用超额值 2,(2 − 1) / 4 会把厚尾那一项缩掉。5.0 是 Pearson。
第 3 步。 紧缩夏普是标准正态在「估计值超过门槛」处的分布函数:
DSR = Φ((ˆSR − SR₀) / ˆSE(ˆSR))
注:函数内部的比值打印到六位是 0.409970,对应概率 0.659086。用表里已经收成六位的 0.346410、0.303672、0.104246 再除,会得到 0.409973,末位差 0.000003。正文以函数内部的六位为准。
只和 0 比、还没放进尝试次数时,同一条标准误给出
PSR = Φ(0.346410/0.104246 的未舍入比值) = 0.999555
| 量 | 六位打印 | 它是什么 |
|---|---|---|
| 月夏普 | 0.346410 | 1.20/√12 |
| Z₀ | 2.530603 | 100 个标准正态最大值的近似期望 |
| SR₀ | 0.303672 | 0.12 × Z₀,选择门槛 |
| 分子 | 1.293205 | 含偏度和 Pearson 峰度 |
| ˆSE | 0.104246 | 选中这一条的标准误 |
| 标准化 | 0.409970 | (ˆSR − SR₀) / ˆSE |
| PSR | 0.999555 | 门槛还放在 0 上 |
| DSR | 0.659086 | 门槛放在 SR₀ 上 |
年化夏普 1.20、十年样本,若只做一次试验,1.20 √10 ≈ 3.79,看起来过了 t > 3。负偏和峰度把标准误从 0.094380 抬到 0.104246;100 次尝试再把要超过的月夏普从 0 抬到 0.303672。剩下的差额只有 0.41 个标准误,概率从 0.999555 降到 0.659086,过不了 0.95。下降主要来自选择门槛,不是来自把夏普乘上 0.58。
0.659086 也不是本轮流程的准入线。docs/workflow.md 开头仍然不用「夏普大于 1」。DSR 要的四样输入是期数、尝试次数、尝试集合的截面标准差、以及这条收益的偏度和峰度。缺一个,就不要套这一个概率。
import math


def norm_cdf(z: float) -> float:
    return 0.5 * (1.0 + math.erf(z / math.sqrt(2.0)))


def norm_ppf(p: float) -> float:
    # 默认环境没有 scipy。80 步二分与绘图脚本同一实现。
    lo, hi = -8.0, 8.0
    for _ in range(80):
        mid = 0.5 * (lo + hi)
        if norm_cdf(mid) < p:
            lo = mid
        else:
            hi = mid
    return 0.5 * (lo + hi)


def deflated_sharpe(
    sr: float,
    sr_std: float,
    n_trials: int,
    n_obs: int,
    skew: float,
    kurtosis: float,
) -> float:
    """夏普与收益同一频率。截面标准差只用来做门槛,不代替这一条的标准误。"""
    gamma = 0.5772156649
    z0 = (1.0 - gamma) * norm_ppf(1.0 - 1.0 / n_trials)
    z0 += gamma * norm_ppf(1.0 - 1.0 / (n_trials * math.e))
    sr0 = sr_std * z0
    # Pearson 峰度。正态是 3;(kurtosis - 1) / 4 才回到 SR^2 / 2。
    scale = 1.0 - skew * sr + (kurtosis - 1.0) / 4.0 * sr * sr
    se = math.sqrt(scale / (n_obs - 1))
    return norm_cdf((sr - sr0) / se)


print(f"{deflated_sharpe(1.20 / math.sqrt(12.0), 0.12, 100, 120, -0.5, 5.0):.6f}")
figures/M08/plot_multiple_testing.py 的 selection_bias_demo 打印上表。可选库没装上时,分位数用上面的二分法,并降级打印 scipy_norm skipped。装上之后,对照调用是 scipy.stats.norm.ppf 与 scipy.stats.norm.cdf。六位结果在未安装时仍以上表为准。
11. 四个分块上的过拟合概率
CSCV 把时间切成几块,反复让一块当模拟考、另一块当期末考。 PBO 是模拟考状元在期末考掉进后半名的比例。这张 4×4 构造矩阵上是 4/6 = 0.666667。 它描述的是这张矩阵上的选择,不是「策略有三分之二的概率是假的」。 换一张构造矩阵,比例就换。训练块 (1,3) 和 (2,3) 的冠军没有掉进后半区。
CSCV(Bailey, Borwein, López de Prado & Zhu, 2017, Journal of Computational Finance 20(4))把时间切成 S 段等长的块,S 为偶数。每次拿 S/2 段做样本内,剩下的做样本外。组合数是 C(S, S/2)。互补的两组都要各算一次,不能只留一半。PBO 是:样本内冠军在样本外的名次落入后半区的比例。名次从 1 起,1 最好。后半区指名次大于列数的一半。
下面 4 行 4 列是构造的分块超额,只用来排序,不是一段行情。列 A、B、C、D 是四条策略。
| 分块 | A | B | C | D |
|---|---|---|---|---|
| 1 | 1 | −3 | 1 | −1 |
| 2 | 7 | 7 | −2 | 2 |
| 3 | 0 | 2 | 8 | 6 |
| 4 | −6 | 4 | 6 | −2 |
C(4, 2) = 6。得分用两块之和。等长时,和与均值的排序相同。四列在每一次切分里都没有并列,所以冠军和名次不依赖排序是否稳定。
| 训练块 | 样本内 A,B,C,D | 冠军 | 样本外 A,B,C,D | 名次 | 后半区 |
|---|---|---|---|---|---|
| 1,2 | 8, 4, −1, 1 | A | −6, 6, 14, 4 | 4 | 是 |
| 1,3 | 1, −1, 9, 5 | C | 1, 11, 4, 0 | 2 | 否 |
| 1,4 | −5, 1, 7, −3 | C | 7, 9, 6, 8 | 4 | 是 |
| 2,3 | 7, 9, 6, 8 | B | −5, 1, 7, −3 | 2 | 否 |
| 2,4 | 1, 11, 4, 0 | B | 1, −1, 9, 5 | 4 | 是 |
| 3,4 | −6, 6, 14, 4 | C | 8, 4, −1, 1 | 4 | 是 |
后半区出现 4 次。
PBO = 4/6 = 0.666667
没有落入后半区的是训练块 (1,3) 和 (2,3)。A 在前两块上是冠军,换到后两块就排到第 4。这是这张构造矩阵上的选择反转,不能写成「真实策略有 ⅔ 的概率过拟合」。列数、分块数或收益换了,比例就换了。
PBO 也不决定账户能不能做空。它只说挑选本身在这张矩阵上有多容易挑中样本内的幸运儿。只做多、杠杆上限 1.0 的账户,仍然不能用一条空头腿去「对冲」这个比例。
import numpy as np

blocks = np.array(
    [
        [1.0, -3.0, 1.0, -1.0],
        [7.0, 7.0, -2.0, 2.0],
        [0.0, 2.0, 8.0, 6.0],
        [-6.0, 4.0, 6.0, -2.0],
    ]
)
# 六种切分都打印。后半区记 1。PBO 是这些 1 的比例。
summary = probability_of_backtest_overfitting(blocks)
真实案例
案例 1:全样本 t 值过了 3,后十年可以不过 0
右图的 t 值来自 M07 同一份 202608 月频,1963-07 至 2026-08 对 2016-01 至 2025-12。动量全样本 t = 3.90,后十年 t = 0.08。投资全样本 t = 3.23,后十年 t = −0.24。价值全样本 t = 2.72,后十年 t = −0.12。盈利后十年仍有 t = 1.48,没有过 1.96。市场后十年 t = 2.60。
这些因子在 1992、1993 年的论文之后并没有立刻失去全样本里的正号。价值从 2006-12 高点到 2020-09 的回撤是 −57.78%,2026-08 仍比该高点低 32.06%(M07)。这和「发表后不久就衰减 58%」不是同一条时间路径。McLean & Pontiff 的 26% 和 58% 是 97 个预测变量的平均降幅,不是 HML 这一列的乘数。
Arnott, Harvey, Kalesnik & Linnainmaa (2021, FAJ 77(1)) 强调价值这段回撤里估值价差的扩大。Maloney & Moskowitz 的 2020 年 5 月工作论文则说明利率并不是稳定的择时信号。两篇都没有授权把后十年的 t = −0.12 写成「价值已被证伪」,也没有授权把 2021 年以来 68 个月的正均值写成「回撤已经结束」。
案例 2:2007 年 8 月的同质减仓
Khandani & Lo (2007, Journal of Investment Management, 第四季度) 用 Lehmann (1990) 与 Lo & MacKinlay (1990) 的反转策略描述 2007-08-06 那一周。这不是 French 的 HML 或 Mom。无杠杆策略在 8 月 10 日回到 +5.92%,当周累计 −0.43%。他们按 2006 年大约 8:1 的杠杆、把无杠杆收益乘以 4 之后,8 月 7 日至 9 日的收益是 −4.64%、−11.33%、−11.43%,三天去掉约四分之一。无杠杆的中间市值组更差,第 4 组三天累计 −9.33%。8 月 9 日标普 500 下跌 2.95%,解释不了 7 日和 8 日市场中性策略已经在跌。论文转述的媒体口径是,一些量化基金当月跌幅在 −5% 到 −30%。那是报道的范围,不是本章重算的基金净值。
机制是:相近的多空持仓被一起减掉,价格冲击再触发下一轮减仓;冲击过去之后,周五出现大幅回升。当周无杠杆 −0.43% 和杠杆后三天约 −25% 可以同时为真。杠杆倍数决定账户看到的是哪一个数。本轮杠杆上限 1.0,复制不了他们的 8:1。周四按亏损砍掉仓位的规则,会离开周五那一笔无杠杆 +5.92% 的回升。这只说明止损改变的是路径,不说明应该在清算周里取消风控。
案例 3:2024 年初的小微盘拥挤
M00 案例 3 的窗口是 2024-01-02 至 2024-02-05 前后。拥挤的小市值暴露加上杠杆产品的减仓,使现货小盘的流动性和超额一起变差。中证 2000 在该窗口下跌约三成,点位以中证指数公司为准。媒体统计的指增超额回撤大约是两位数,各家样本不同。本章不另给一个超额百分比。
Hou、Xue 与 Zhang 的交易摩擦一类里,96% 过不了 ‖t‖ ≥ 1.96。小盘、低价差股票上的研究溢价,和个人账户能成交的部分不是同一个数。港股还要加上指定可沽空名单和印花税。等权或微盘上的 t 值,先经过这两项再谈有没有增量。
方法论来源
| 概念 / 模型 | 核心文献或规范出处 |
|---|---|
| 因子动物园 | Cochrane (2011), JF 66(4);Harvey, Liu & Zhu (2016), RFS 29(1) |
| Holm | Holm (1979) |
| BH 与 BHY | Benjamini & Hochberg (1995);Benjamini & Yekutieli (2001) |
| 夏普标准误 | Lo (2002),夏普为 0 时约为 1/√Y |
| Deflated Sharpe 与 PBO | Bailey & López de Prado (2014), JPM 40(5);Bailey, Borwein, López de Prado & Zhu (2017), Journal of Computational Finance 20(4)。月频手算见第 10–11 节 |
| 推荐门槛 | Harvey, Liu & Zhu 建议 t 大于 3.0。316 个检验的临界值不是他们的推荐值 |
| 图 | plot_multiple_testing.py,种子 7 |
💡 思考回顾与巩固
核心认知纠偏
| 误区 | 反例 | 用法 |
|---|---|---|
| 1000 次检验大约 50 次显著,所以相关一高,假阳性就会少很多 | 期望个数始终是 mα。全相关时,次数是 0 或 1000,概率 5% 时期望仍是 50 | 相关改变的是最大值和主题是否重复 |
| t > 3 就是 316 次独立 Bonferroni | 独立 Bonferroni 在 m = 316 时是 3.78。HLZ 的建议是大于 3.0,并允许相关 | 两个门槛分开引用 |
| 发表后衰减 58%,所以夏普 1.2 的未来值是 0.50 | 58% 是 97 个预测变量的收益降幅。零溢价、200 次尝试、十年样本的最大夏普均值是 0.868 | 不把 0.58 乘到任意夏普上 |
| 回测夏普要统一打五折 | Harvey & Liu (2015) 的折扣随尝试次数变。本章首项近似 1.03,模拟均值 0.87 | 先数 m,再算原假设下的最大值 |
| 原论文复现了,就说明换市值加权仍然显著 | Chen & Zimmermann 的 98% 是原方法。HXZ 的 65% 失败是另一套持仓 | 两套设计都要写 |
| 全样本 t > 3 的因子,后十年不会接近 0 | 动量 3.90 对 0.08,投资 3.23 对 −0.24 | 后一段窗口和全样本一起报 |
| 2007 年 8 月当周策略只跌了 0.43%,所以杠杆账户也一样 | 无杠杆当周 −0.43%;他们的 8:1 三天约 −25% | 写明杠杆 |
| 一次种子的最大夏普 0.969,说明夏普超过 1 不会出现 | 20,000 次里有 14.5% 的实验至少出现一条 | 用分布,不用一次抽样 |
| 年化夏普 1.20 的 DSR 仍接近 1 | 月频上 PSR 是 0.999555,放进 100 次尝试后 DSR 是 0.659086 | 门槛用 SR₀,不是把夏普乘 0.58 |
费曼自测
- 为什么检验相关时,假阳性个数的期望仍然是 mα?那相关还改变了什么?
- 同一组 20 个 p 值,为什么 Holm 拒绝 1 个、BH 拒绝 2 个?
- 十年样本里 t 从 1.96 提到 3,夏普门槛上升多少?这和「打五折」是同一个操作吗?
- Chen & Zimmermann 的 98% 和 Hou、Xue 与 Zhang 的 65% 失败率,哪一个在说可投资组合?
自测要点
1. 期望可加,不需要独立性。每个 Iⱼ 的期望都是 α,加起来就是 mα。相关改变个数的方差,也改变最大 t 值的分布。因子若是同一主题的副本,独立 Bonferroni 会把它们当成 316 次互不影响的测试,门槛偏严。 2. Holm 在第二个 p 值 0.004 处对着 0.002632 失败,并且停止。BH 允许第二个 p 值对着 0.005 通过,第三个 0.012 对着 0.0075 失败,所以最大 k = 2。BH 控制的是发现集合里的假阳性比例,不是「一个假阳性都不许有」。 3. 1.96/√10 = 0.620,3/√10 = 0.949,上升 0.329。打五折会把 0.620 收到 0.310,那是另一个数。尝试次数上升时,原假设下的最大夏普会上移,上移多少要用 m 和年数算,不能用固定成数。 4. 98% 是沿原论文做法复现 t > 1.96 的比例。65% 是换成 NYSE 断点和市值加权之后 ‖t‖ 达不到 1.96 的比例。更接近「可投资、且不被微盘主导」的是后者。前者说明原文结果多半不是算错,而是换规则之后会变。四维习题
A. 概念题
- 写出假阳性个数期望等于 mα 的理由。相关为什么不能拿来把 50 改小?
- Harvey、Liu 与 Zhu 的 t > 3 从哪来?它为什么不等于 m = 316 的独立 Bonferroni 临界值 3.78?
- 列出发表后收益变小的三类原因,每一类对上哪一篇文献或本章的哪一张表。
- 一个策略上线之后落后于回测,怎样区分「还在历史回撤里」「月均已经下降」和「交易制度变了」?
B. 计算题
- 用第 3 节的 20 个 p 值复核 Bonferroni、Holm 和 BH 各拒绝几个。
- 样本 10 年和 50 年,分别计算 t = 1.96 和 t = 3 对应的年化夏普。
- 计算 √(2 ln 200) / √10。它和模拟得到的最大夏普均值 0.868 为什么不一样?
- 三年、夏普 1.5,以及二十年、夏普 0.6。计算两个 t 值。哪一个离 t = 3 更近?
- 用第 10 节的输入,写出月夏普、Z₀、SR₀、ˆSE、PSR 和 DSR。为什么年化夏普 1.20 不能直接代进标准误?
- 第 11 节的六次切分里,哪两次的冠军没有落入后半区?PBO 是多少?这个比例是不是「策略有 ⅔ 的概率是假的」?
C. 编程实战题
- 运行
figures/M08/plot_multiple_testing.py,核对 20,000 次模拟的均值 0.868、95% 分位 1.097,以及至少一条夏普超过 1 的比例 14.5%。 - 在同一输出里核对六条 French 因子的全样本 t 和 2016–2025 的 t。确认右图用的是 iid t,不是 Newey–West。
- 把脚本里的日频那一次单独改到种子的第一步,说明最大夏普不必仍是 0.969。本章引用的 0.969 依赖脚本里的抽取顺序。
D. 个人实战思考题
- 你试了 30 组参数,只把夏普最高的一组写进实验模板。清单上的「尝试次数」应填多少?这和 Bonferroni 的 m 是什么关系?
- 杠杆上限 1.0。Khandani 与 Lo 的 8:1 三天跌幅,哪一部分不能当成你的账户路径?
- 港美股账户准备检验一个新的月频特征。在看收益之前要写下哪四项,才能和本章的图对上?
完整参考答案与解析
**A1.** Iⱼ 是第 j 次被拒绝的指示变量,E[Iⱼ] = α。和的期望等于期望的和,所以总数的期望是 mα,无论 Iⱼ 是否相关。m = 1000、α = 0.05 时期望是 50。全相关时,要么一次都不拒绝,要么 1000 次一起拒绝;后者的概率若是 0.05,期望仍是 50。相关改变的是你看到的「独立主题」个数,以及最大 t 值。 **A2.** 316 是他们从 313 篇文章里数出的因子个数,并且低于未发表的失败测试。大于 3.0 是那篇论文的多重检验建议;附录里的 BHY 门槛约 3.05。独立、双侧、族错误率 5% 的 Bonferroni 在 m = 316 时是 3.778。后者把每次检验当成互不相关。因子主题相关时,这个 3.78 偏严。两个数都不要写成对方。 **A3.** 统计筛选:本章第 1 节的 50 次假阳性,以及 Harvey、Liu 与 Zhu 对未发表失败测试的提醒。套利和拥挤:McLean & Pontiff 把发表后相对样本外多出来的约 32 个百分点联系到按论文交易;案例 2 的 2007 年 8 月是同质持仓被一起减掉。交易成本:Novy-Marx & Velikov 按换手分类;M00 的港股印花税是个人账户上的对应项。三者都不是「夏普乘 0.42」。 **A4.** 先看亏损是否还落在回测已经出现过的回撤分布里,并记住六个月的夏普误差很大,常常做不成拒绝。再看同一条定义在预先留下的后一段窗口里,月均和 t 值是否还在,M07 的 2016–2025 就是这种对照。最后看交易规则是否变了,例如卖空名单、印花税、杠杆上限。制度变了就不是同一条策略的回撤。 **B5.** Bonferroni 临界值 0.0025,只有 0.001 通过。Holm 第一步临界值同样是 0.0025,通过;第二步 0.05/19 = 0.002632,0.004 失败并停止,只拒绝 1 个。BH 第二步临界值 0.005,0.004 通过;第三步 0.0075,0.012 失败。最大 k = 2,拒绝前两个。 **B6.** 10 年:1.96/√10 = 0.620,3/√10 = 0.949。50 年:1.96/√50 = 0.277,3/√50 = 0.424。同样的 t 门槛,样本越短,要求的夏普越高。 **B7.** ln 200 = 5.2983,2 ln 200 = 10.5966,平方根 3.255。除以 √10 得 1.029。模拟均值 0.868 更低,因为标准正态最大值的期望比首项 √(2 ln m) 小。本章引用分布时用 0.868 和 95% 分位 1.097,首项只用来看量级。 **B8.** 1.5 √3 = 2.598,0.6 √20 = 2.683。二十年的 t 值略高,两者都低于 3。离 3 更近的是 2.683。证据强度接近,但二十年覆盖的制度更多。短样本上为了让 t 超过 3,夏普要到 3/√3 = 1.732,高于这里的 1.5。 **B9.** 月夏普 0.346410,Z₀ = 2.530603,SR₀ = 0.303672,分子 1.293205,ˆSE = 0.104246,标准化 0.409970,PSR 0.999555,DSR 0.659086。1.20 已经乘过 √12。标准误的 T − 1 = 119 是月数。把 1.20 和 120 放进同一条式子,频率就错了。用六位表内的三个数再除,得到的是 0.409973,不采用。 **B10.** 训练块 (1,3) 和 (2,3) 的名次是 2,没有进入后半区。其余四次进入。PBO = 4/6 = 0.666667。这是这张 4×4 构造矩阵上的比例,不是一条策略为假的概率。换矩阵,比例就换。 **C11–C13.** 与 `figures/M08/plot_multiple_testing.py` 同一契约。种子 7。20,000 次渐近模拟:最大夏普均值 0.868,95% 分位 1.097,至少一条超过 1 的比例 0.145,超过 0.5 的期望条数 11.42。日频那一次发生在渐近模拟之后:最大夏普 0.969,超过 1 的有 0 条,超过 0.5 的有 11 条。French 六列的 t 值就是案例 1 和第 5 节的图,标准误按月收益独立同分布,没有 Bartlett 核。把日频抽到种子的第一步会换成另一条路径,0.969 不再适用。同一脚本还打印 DSR 0.659086、PBO 0.666667,以及 `scipy_norm skipped`。import math
import numpy as np
def record_trials(tried: int, reported: int) -> int:
"""多重检验的 m 用试过的规格数。只汇报最优的那一次时,reported 不能代替 tried。"""
if tried < reported:
raise ValueError("尝试次数不能少于写进结论的规格数")
return tried
def sharpe_hurdle(t_star: float, years: float) -> float:
# 年数用样本长度除以一年的期数。月频是 T/12,日频是 n/252。
return t_star / math.sqrt(years)
📌 章节知识总结
一句话核心洞察
- 1000 次水平 5% 的检验,在全是噪声时期望有 50 次显著。相关不改变这个期望。
- 独立 Bonferroni 在 316 次时是 ‖t‖ > 3.78。Harvey、Liu 与 Zhu 的建议是 t > 3.0,两者不是同一个门槛。
- 十年样本上,t = 3 对应夏普 0.949,t = 1.96 对应 0.620。这不是把夏普乘以 0.42 或 0.5。
- 200 条零溢价、十年样本,最大夏普的模拟均值是 0.868,95% 分位 1.097。首项近似 1.029 偏高。
- 动量的全样本 t = 3.90,2016–2025 的 t = 0.08。原方法能复现,和后一段窗口仍然显著,是两件事。
- 年化夏普 1.20 在这组月频输入下,PSR 是 0.999555,DSR 是 0.659086。下降来自选择门槛和厚尾,不是乘上 0.58。
- 四块矩阵的 PBO 是 0.666667。它只描述这张构造矩阵上的选择,不写成策略为假的概率。
公式与样本
| 对象 | 表达式或数值 | 前提 |
|---|---|---|
| 假阳性期望 | mα | 期望可加,不要求独立 |
| Bonferroni | 临界 p 为 α/m | 20 次、5% 时为 0.0025 |
| Holm 第二步 | α / (m − k + 1) | 0.004 对 0.002632 失败 |
| BH | 最大 k 使 p₍ₖ₎ ≤ α k/m | 本例 k = 2;假定独立 |
| m = 316 的独立临界 t | 3.778 | 双侧,族错误率 5% |
| HLZ | t > 3.0 | 他们的框架;316 偏低 |
| 夏普门槛 | t/√Y | 独立收益;月频 Y = T/12 |
| 十年、t = 3 | 夏普 0.949 | 3/√10 |
| 最大夏普首项 | √(2 ln m) / √Y | m = 200、十年时为 1.029 |
| 模拟均值 | 0.868 | 20,000 次,种子 7 |
| 2016–2025 动量 t | 0.08 | 全样本 3.90;iid |
| McLean & Pontiff | 样本外约 −26%,发表后约 −58% | 97 个预测变量的收益,不是夏普乘数 |
| 月夏普 | 0.346410 | 1.20/√12,T = 120,M = 100 |
| Z₀ 与 SR₀ | 2.530603 与 0.303672 | σ_({ˆSR}) = 0.12,与收益同频率 |
| ˆSE | 0.104246 | 偏度 −0.5,Pearson 峰度 5.0,分母 T − 1 |
| PSR 与 DSR | 0.999555 与 0.659086 | 门槛从 0 换成 SR₀ |
| PBO | 0.666667 | S = 4,6 种切分里 4 次落入后半区 |
跨模块
| 结论 | 交给 | 位置 |
|---|---|---|
| t = SR √Y | 短样本高夏普和长样本普通夏普可以有相近的 t | M01 |
| 尝试次数含放弃的规格 | 实验记录 | ../../../docs/workflow.md,../../../research/templates/experiment_template.md |
| 后一段窗口的 t 值 | 不要只留全样本 | M07,../figures/M08/multiple_testing.png |
| 原方法复现不等于市值加权仍显著 | 复制率必须带口径 | M06 |
| 8:1 的三天跌幅 | 杠杆上限 1.0 的账户走不到 | M04,../../../docs/risk_policy.md |
| 2024 年初小微盘 | 约三成是中证 2000 的指数跌幅 | M00 案例 3 |
| 公告日上的事件 | 不把月频 t 值挪去当持有期 | M19 |
| 只做多账户上的第二层过滤 | 不靠空头腿消化多次尝试 | M16 |
学习指引
- 精读:因子第 6 章的数据窥探、发表后失效和行为解释。黑箱第 9 章先写假设、第 11 章对回测数量的批评。陈 3.4 的数据窥探和本章第 5 节是同一件事。
- 对照:26% 与 58% 只描述 McLean & Pontiff 的 97 个预测变量。French 窗口以 M07 和本章脚本的打印为准。
- 项目:不把 t > 3 或「夏普大于 1」写回本轮准入。尝试次数继续记在实验模板已有的那一栏。
- 下一步:M09 把留下的信号放进信息比率和广度。本章的模拟说明,广度若来自反复试参数,而不是来自新的独立赌注,信息比率的公式用不上。
自检清单
- 能说明 1000 次检验的期望假阳性是 50,而且相关不改变这个期望
- 能手算 20 个 p 值上 Holm 拒绝 1 个、BH 拒绝 2 个
- 能把十年样本的 t = 3 换算成夏普 0.949,并说出它不是 58% 折扣
- 能复述最大夏普的模拟均值 0.868、95% 分位 1.097,以及一次日频抽样的 0.969 为什么不能单独引用
- 能把 Chen & Zimmermann 的 98%、HXZ 的 65% 和 JKP 的 55.6% 与 82.4% 各放回它们的定义
- 能指出 2007 年 8 月无杠杆当周 −0.43% 和 8:1 三天约 −25% 来自同一篇论文的两种杠杆
- 能复述这组月频输入下的 DSR 0.659086,并说明它不是 PSR 0.999555,也不是夏普乘 0.58
- 能用手算四块矩阵的 PBO 0.666667,并指出 (1,3) 与 (2,3) 没有落入后半区